獨立章節 8 — 台灣自主低軌通訊衛星群的數位工程觀點
taiwan_leo_constellation/PLAN.md
獨立章節企劃:台灣自主低軌通訊衛星群的設計,從規格到營運
狀態:已完成。本檔是施作前的企劃,保留供對照;實際結果與結論見 TaiwanLEO_Decision_Brief.md(決策摘要)與 TaiwanLEO_Primer.md(導論)。
其中第 8 節「風險」所列的限制,多數在施作過程中被具體化了 —— 最重要的是:涵蓋最佳的星座設計會讓衛星相撞,最佳化必須加上最小距離限制。
1. 定位
| 項目 | 決定 |
|---|---|
| 主場景 | 海纜中斷備援 + 離島與 100 海浬經濟海域 |
| 星座規模 | 掃描 24~240 顆(Trade Study,結論不預設) |
| 架構比較 | 彎管 vs 再生式酬載;具星間鏈路(ISL)的衛星比例 1/6、1/12、1/24 |
| 成本 | 納入(第 10 節) |
| 受眾 | 課程學生 + 有意進入太空產業的財務長 |
| 發布 | 電子書網頁版、Dataset、Space(比照現有) |
| 工具 | STK 13.1.0(驗證與視覺化)+ Python(大規模掃描) |
一句話的核心問題: 規模受限的自主星群,在海纜中斷時能提供多少服務、付出多少成本,又該在哪裡設定「夠用」的線?
兩種讀者要的不一樣,章節要分層:
學生要看到方法與可重現的程式;財務長要看到決策指標(每位元成本、成本與可用度的取捨、敏感度),不需要軌道力學。
做法:每節開頭固定一個「給決策者的一頁」(結論、假設、風險),其後才是方法。
2. 場景定義(第 1 節要先釘死的事)
- 服務區: 台灣本島、澎湖、金門、馬祖、東沙、太平島,以及它們周邊 100 海浬的海域。
- 「100 海浬」的量法(自領海基線算、或自各島海岸算)必須在第 1 節明寫,並用同一個多邊形進行所有涵蓋計算。
- 這個範圍小於法定專屬經濟海域(200 海浬);章節會註明這是研究範圍的選擇。
- 海纜中斷情境: 本島對外海纜全斷、僅離島間或單一海纜斷兩種。這決定「備援要承載多少流量」。
- 服務等級(要變成可量測指標):
| 等級 | 對象 | 指標 |
|---|---|---|
| A 生命線 | 政府、醫療、緊急通訊 | 可用度、延遲、最低速率 |
| B 離島與海上 | 離島居民、漁船、海巡 | 涵蓋率、每用戶速率 |
| C 一般回傳 | 商用備援 | 容量、價格 |
3. Trade Study 設計
3.1 設計變數
| 變數 | 範圍 |
|---|---|
| 星數 N | 24, 36, 48, 72, 96, 144, 192, 240 |
| 軌道高度 | 550, 800, 1200 km |
| 傾角 | 約 25°(區域優化)、53°、70°、97°(太陽同步) |
| 軌道面數 P | 依 N 取 Walker 允許的因數 |
| ISL 比例 f | 1/6、1/12、1/24(具星間鏈路的衛星占比) |
| 酬載 | 彎管、再生式(星上處理與交換) |
| 最低仰角 | 25°、35°、40° |
| 境內閘道站 | 1、2、3 座(台灣本島內) |
完整組合很大,不做全因子:第一輪用分數因子 / 拉丁超立方抽樣縮小,再對有潛力的區域加密。
3.2 評估指標
- 服務區涵蓋可用度(時間 %)與最長中斷。
- 端到端延遲(使用者到境內閘道;彎管需同時看到閘道,再生式可經 ISL 繞行)。
- 容量:波束數、頻寬、同時用戶的簡化模型。
- 韌性:單星失效、閘道失效、海纜中斷下的剩餘服務。
- 成本:資本支出、營運支出、每位元成本。
3.3 方法分工(沿用本教材的作法)
- 大量掃描用 Python 解析 / SGP4:速度快,可以跑數千組。
- STK 13.1.0 驗證關鍵候選點:重算涵蓋與鏈路,和 Python 結果交叉比對。
- 每個結論附獨立檢查(閉合式或第二套實作),延續「ACK 不等於生效」。
3.4 ISL 與再生式比較的邏輯
- 彎管:衛星必須同時看到使用者與境內閘道。台灣本土面積小,閘道站少時,可用度會被閘道可視性限制。
- 再生式 + ISL:資料可經星間鏈路繞到看得見閘道的衛星,代價是衛星複雜度與成本。
- f = 1/6、1/12、1/24 代表「少數衛星當路由節點」的稀疏骨幹;要檢查稀疏骨幹是否能連通(圖論連通性、跳數、延遲)。
- 預期有一個「ISL 比例不夠就等於沒有」的門檻,這是本節要用數據找出來的,不預設。
4. 章節大綱(10 節)
| 節 | 主題 | 給決策者的一頁 | 方法與產出 |
|---|---|---|---|
| 1 | 需求變規格 | 服務等級與指標 | 需求追溯表、服務區多邊形 |
| 2 | 軌道與星座選擇 | 星數與高度的取捨 | Walker 掃描、涵蓋與重訪圖 |
| 3 | 台灣緯度特性 | 區域星座為何有效 | 傾角與涵蓋熱圖 |
| 4 | 鏈路預算 | 終端大小與餘裕 | 用戶/饋線鏈路、降雨、TIREM 地形 |
| 5 | 彎管 vs 再生式 + ISL | ISL 值不值得 | f = 1/6、1/12、1/24 的連通性、延遲、可用度 |
| 6 | 容量 | 能服務多少用戶 | 波束與頻寬模型 |
| 7 | 韌性 | 壞掉時還剩多少 | 失效情境矩陣(抽象的可用度分析) |
| 8 | 衛星壽命與補網 | 要買幾顆、多久補一次 | 壽命、離軌、補網與發射排程、避碰 |
| 9 | 營運 | 地面段與日常運作 | 測控排程、換手、避碰、KPI |
| 10 | 成本 | 單位成本與取捨 | 資本與營運成本模型、敏感度分析 |
5. 第 10 節(成本)的設計原則
財務長讀者最容易被「一個數字」誤導,所以:
- 全部以區間與情境呈現,不給單點估計。
- 每個成本參數標明來源類別:公開資料(附出處)、類比推估、純假設。不編造報價。
- 結構:
- 資本支出 = 衛星 × 單價 × 學習曲線 + 發射 + 地面段 + 終端補貼。
- 營運支出 = 測控 + 補網 + 保險 + 人力 + 頻譜與執照。
- 輸出指標:總擁有成本、每位元成本、成本對可用度曲線。
- 敏感度分析: 龍捲風圖,看哪些參數(衛星單價、壽命、發射價)最影響結論。
- 對照: 備援價值只以情境假設表示(例如一天中斷損失的假設區間),明講這是假設。
- 章節不做投資建議。
6. 可沿用與需新做
| 類別 | 已有 | 需新做 |
|---|---|---|
| 星座與涵蓋 | 第 16 週 Walker、constellation_analyzer.py |
區域優化傾角掃描、服務區多邊形、分數因子掃描 |
| 鏈路 | 第 11 週、tirem_coastal、comm_taiwan_groundstations.py |
區域終端與波束模型 |
| 多軌道對照 | moda_satapp 七場景、OneWeb / O3b / GEO 公開星曆 |
自主星群與公開星群對照 |
| 營運 | 第 14 週通聯排程 | 星群級測控排程 |
| 發射與避碰 | launch_conjunction、spaceport_suborbital |
補網節奏 |
| 全新 | ISL 稀疏骨幹連通性、再生式模型、容量模型、韌性矩陣、成本模型 |
大約一半的方法可沿用;全新的重點是 ISL、容量、韌性、成本。
7. 交付物
- 章節文稿(Markdown),與其他獨立章節同格式,每節有「給決策者的一頁」。
- Python 模組與驗證段(每個結論附獨立檢查)。
- STK 13.1.0 場景、截圖、影片(關鍵候選方案)。
- Notebook(與
stk13_labs/同格式,含 STK 13.1.0 實測輸出)。 - 簡報(學生版與財務長版各一份)。
- 電子書網頁版、Dataset、Space 更新,PDF 重出。
8. 風險與限制
- 沒有真實設計資料。 星座、終端、成本全是研究假設;每個數字標明是假設或有來源。章節標題與內文不宣稱代表任何實際計畫。
- 公開資料有限。 頻譜、ITU 申報與法規只做概念說明,不是法律意見。
- STK 授權。 過去曾到期;目前 STK 13.1.0 可用,STK 部分應集中在授權期內完成。
- 成本不確定性大。 這是最容易被誤讀的一節,因此只用區間與情境。
- 失效與干擾情境 只做抽象可用度分析,不寫攻擊細節。
- ISL 與再生式的工程細節(功耗、質量、時脈同步)只用簡化模型,並標明適用範圍。
9. 工作順序
- 基礎(節 1~4): 服務區、星座掃描、鏈路預算。後面都依賴它,最先做。
- 架構與容量(節 5~7): ISL 稀疏骨幹、再生式、容量、韌性。
- 營運與成本(節 8~10): 補網、營運、成本模型。
- 整合: 簡報、網頁版、Dataset 與 Space、PDF。
每個階段結束時用本教材慣用的驗證段與失敗注入各檢查一次,再進下一階段。
10. 已確認的決定
| 項目 | 決定 |
|---|---|
| 100 海浬的量法 | 自各島海岸算起(100 海浬 = 185.2 km) |
| 境內閘道站 | 無指定地點,用本島東、西、南各一座的泛用假設 |
| 成本參數 | 無內部資料;用公開文獻區間,逐項標註來源類別 |
| 章節名稱 | 獨立章節 8 — 台灣自主低軌通訊衛星群的數位工程觀點 |
「數位工程觀點」的意思:整章用一條可追溯的數位線索 —— 需求 → 模型 → 掃描 → 驗證 → 決策 ——
每個結論都能回到參數與程式重算,並附獨立驗證;這也是本教材一貫的作法。
TaiwanLEO_Decision_Brief.md
給財務長的決策摘要 — 台灣自主低軌通訊衛星群
先讀這段。 本摘要的所有數字都是研究假設(類別 A),沒有任何一項來自特定計畫或廠商報價,也不是投資建議。價值在結構:哪些項目驅動成本、成本對哪些參數敏感、哪些結論經過獨立驗證。使用前請以實際報價取代成本參數。金額單位:百萬美元(M USD),未換算匯率。
一頁結論
問題: 海纜中斷時,以規模受限的自主低軌星座提供台灣本島、離島與 100 海浬海域的備援通訊,能提供多少服務、要付出多少成本?(基準需求 17.1 Gbps,為假設。)
- 能滿足基準需求 99% 以上、且 14 年總成本最低的設計:1200 km、96 顆,基準 TCO 約 2628 M USD(低 / 高情境 1117 ~ 6397;蒙地卡羅 P10~P90 2391 ~ 3739)。
- 但這個高度與既有的 OneWeb 星座在同一個殼層:24 小時內與 OneWeb 近距離(50 km 內)事件約 4787 件(篩選等級)。成本最低不等於可行 —— 交會迴避的運作負擔與風險沒有算進 TCO。 - 成本對兩個參數最敏感:第一顆衛星的量產成本 與 每次發射單價(龍捲風圖第一、第二)。研發、地面段與人力不是主要因素。
- 營運期的補網(衛星 + 發射 + 保險)佔總成本 54~58%:衛星有壽命,星座要持續補造。這是財務模型最容易低估的一項。
- 容量由衛星的饋線頻寬決定,不是使用者波束。 饋線頻寬翻倍,容量幾乎翻倍;「買一倍饋線頻譜」與「多一倍衛星」在容量上近乎等價,成本差別很大 —— 值得優先比較。
- 星間鏈路 + 再生式只對太平島有意義,而且只在全部衛星都具備時才大幅改善;稀疏的 1/24、1/12、1/6 效益很小,到 1/6 也只多出數個百分點(見表 3)。較高的軌道高度能用更低的成本達到類似效果。
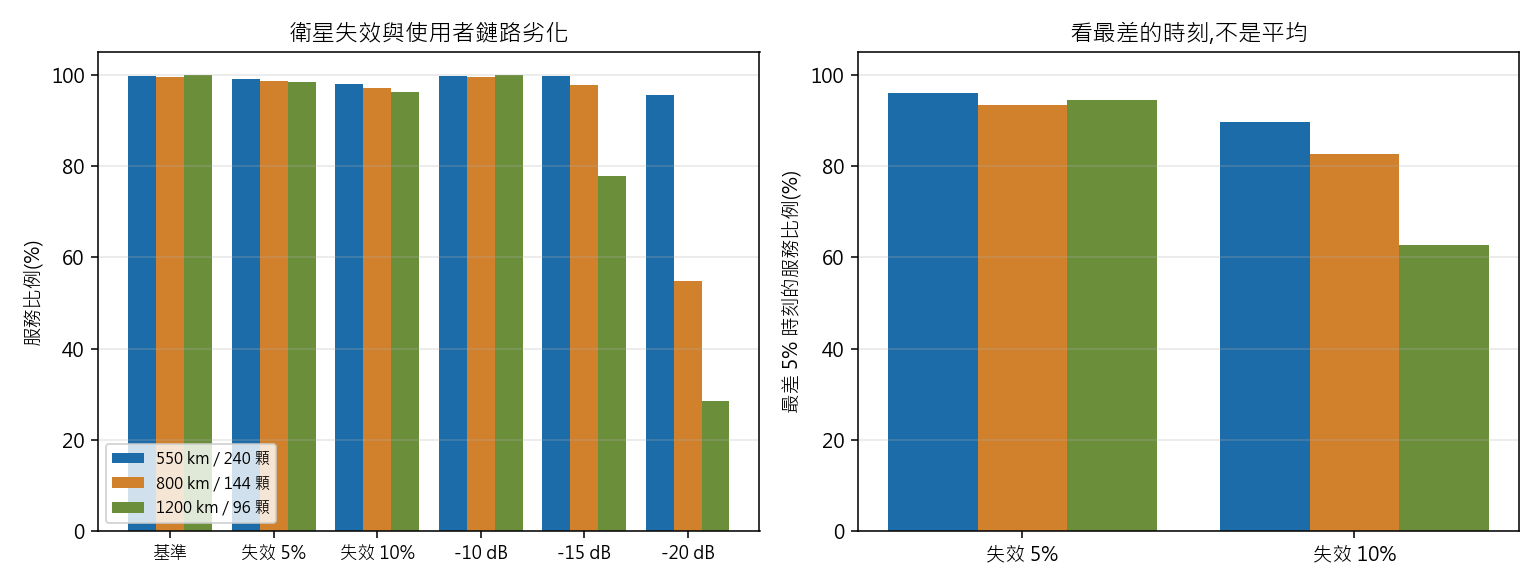
- 平均服務比例會掩蓋中斷。 衛星失效 10% 時,平均只掉 2~4 個百分點,但最差 5% 時刻的服務比例只剩 63~90%。
圖:服務比例對成本
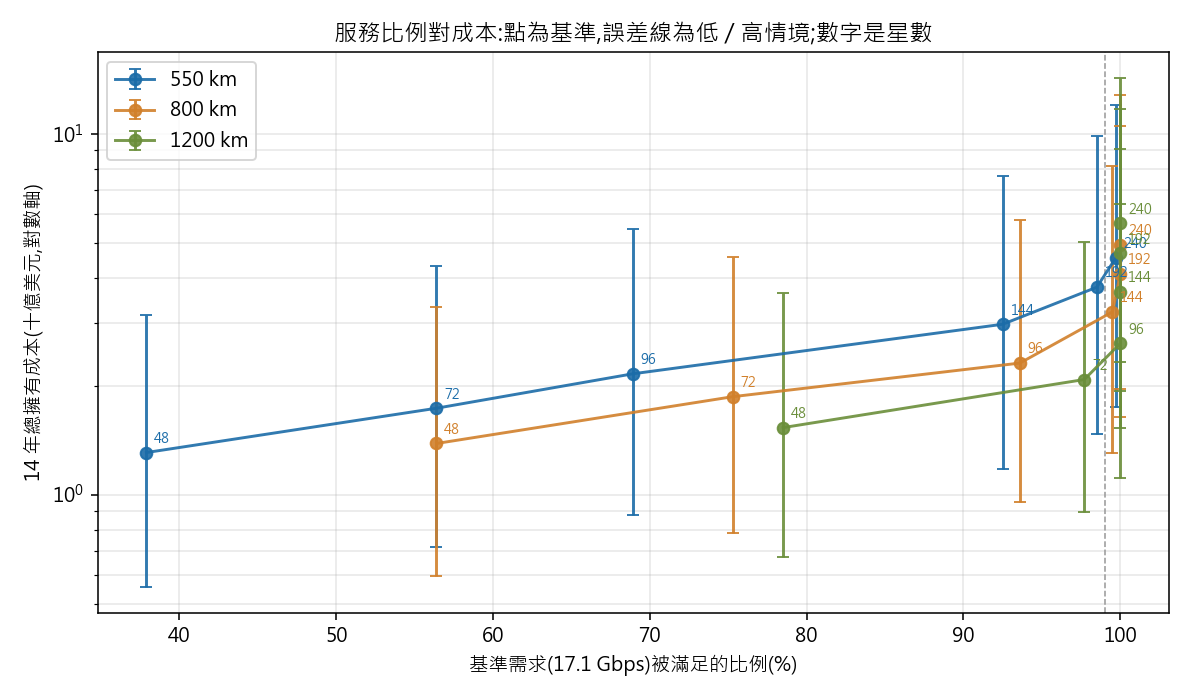
表 1:設計選項(傾角 25°,最佳相位且衛星間最近距離 ≥ 20 km)
| 高度 km | 星數 | 服務比例 | 服務比例(最差 5%) | 容量上限 Gbps | TCO 低 | TCO 基準 | TCO 高 | MC P10 | MC P90 | 年化 M USD | 每 GB(USD) |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 550 | 48 | 0.379 | 0.000 | 10.2 | 555 | 1310 | 3159 | 1214 | 1841 | 94 | 3.66 |
| 550 | 72 | 0.564 | 0.288 | 14.9 | 717 | 1738 | 4297 | 1580 | 2471 | 124 | 3.26 |
| 550 | 96 | 0.689 | 0.552 | 19.9 | 878 | 2164 | 5438 | 1946 | 3098 | 154 | 3.33 |
| 550 | 144 | 0.925 | 0.697 | 30.1 | 1178 | 2969 | 7645 | 2624 | 4307 | 212 | 3.40 |
| 550 | 192 | 0.985 | 0.932 | 40.1 | 1473 | 3760 | 9837 | 3297 | 5489 | 269 | 4.04 |
| 550 | 240 | 0.997 | 0.969 | 50.0 | 1755 | 4524 | 11982 | 3928 | 6643 | 323 | 4.80 |
| 800 | 48 | 0.564 | 0.412 | 14.4 | 595 | 1388 | 3319 | 1291 | 1946 | 99 | 2.61 |
| 800 | 72 | 0.753 | 0.552 | 21.9 | 785 | 1871 | 4570 | 1713 | 2653 | 134 | 2.63 |
| 800 | 96 | 0.936 | 0.678 | 29.0 | 958 | 2318 | 5759 | 2097 | 3315 | 166 | 2.62 |
| 800 | 144 | 0.995 | 0.963 | 43.8 | 1305 | 3213 | 8151 | 2862 | 4654 | 230 | 3.42 |
| 800 | 192 | 1.000 | 1.000 | 58.0 | 1643 | 4090 | 10519 | 3607 | 5955 | 292 | 4.33 |
| 800 | 240 | 1.000 | 1.000 | 71.8 | 1965 | 4931 | 12825 | 4322 | 7218 | 352 | 5.22 |
| 1200 | 48 | 0.785 | 0.554 | 21.3 | 672 | 1536 | 3626 | 1439 | 2156 | 110 | 2.07 |
| 1200 | 72 | 0.977 | 0.854 | 31.7 | 897 | 2087 | 5018 | 1921 | 2950 | 149 | 2.26 |
| 1200 | 96 | 1.000 | 1.000 | 42.4 | 1117 | 2628 | 6397 | 2391 | 3739 | 188 | 2.78 |
| 1200 | 144 | 1.000 | 1.000 | 63.8 | 1530 | 3651 | 9054 | 3272 | 5254 | 261 | 3.87 |
| 1200 | 192 | 1.000 | 1.000 | 84.8 | 1940 | 4663 | 11705 | 4145 | 6753 | 333 | 4.94 |
| 1200 | 240 | 1.000 | 1.000 | 106.2 | 2334 | 5645 | 14300 | 5003 | 8213 | 403 | 5.98 |
表 1b:使用者終端最低仰角對所需星數的影響(傾角 25°,最佳相位且最近距離 ≥ 20 km)
| 高度 km | 25° 達 95% | 25° 達 99% | 40° 達 95% | 40° 達 99% |
|---|---|---|---|---|
| 550 | 96 | 144 | > 240 | > 240 |
| 800 | 72 | 72 | 144 | 240 |
| 1200 | 36 | 48 | 96 | 96 |
數字是所需的最少衛星數(掃描範圍 24~240 顆;「> 240」表示範圍內達不到)。終端的最低仰角是主要的成本驅動項:門檻從 25° 提到 40°,所需星數大幅增加。
TCO 單位 M USD,14 年(研發 3 + 部署 1 + 營運 10),含補網。「服務比例」是基準需求被滿足的時間平均比例。「每 GB」= 年化成本 / 基準需求被滿足的年流量。
表 2:最敏感的成本參數(以 1200 km、96 顆為例,基準 TCO 2628 M USD)
| 參數 | 代號 | 取低值時 TCO | 取高值時 TCO | 幅度 |
|---|---|---|---|---|
| 第一顆衛星的量產成本 | c1_sat | 1983 | 3756 | 1773 |
| 每次發射單價 | launch_cost | 2164 | 3620 | 1456 |
| 學習率(越小學得越快) | learning | 2227 | 3185 | 958 |
| 衛星研發與鑑定(NRE) | nre_sat | 2568 | 2758 | 190 |
| 保險費率(佔該批衛星與發射價值) | insurance | 2564 | 2712 | 148 |
| 維運人力 | staff_fte | 2605 | 2673 | 68 |
| 軟體與資安(每年) | software_year | 2608 | 2668 | 60 |
| 閘道追蹤天線(每具) | gw_antenna | 2604 | 2658 | 54 |
表 3:星間鏈路 + 再生式的邊際價值(只看太平島可用度)
| 高度 km | 星數 | 具 ISL 比例 | 具 ISL 顆數 | 多花 M USD | 太平島可用度增加(百分點) | 每增加 1 點(M USD) |
|---|---|---|---|---|---|---|
| 550 | 144 | 1/12 | 12 | 41 | 0.34 | 120 |
| 550 | 144 | 1/6 | 24 | 82 | 2.67 | 31 |
| 550 | 144 | 1/1 | 144 | 490 | 28.03 | 18 |
| 800 | 144 | 1/12 | 12 | 41 | 0.09 | 454 |
| 800 | 144 | 1/6 | 24 | 82 | 0.31 | 263 |
| 800 | 144 | 1/1 | 144 | 490 | 2.04 | 240 |
| 1200 | 96 | 1/12 | 8 | 27 | 0.00 | — |
| 1200 | 96 | 1/6 | 16 | 54 | 0.00 | — |
| 1200 | 96 | 1/1 | 96 | 326 | 0.00 | — |
「—」表示增加不到 0.05 個百分點。溢價用每顆 1.0 M USD(假設)計。
表 4:韌性(基準需求,晴天)
| 高度 km | 星數 | 基準 | 失效 5% | 失效 10% | 失效 10% 最差5%時刻 | 鏈路 -10 dB | 鏈路 -15 dB | 鏈路 -20 dB |
|---|---|---|---|---|---|---|---|---|
| 550 | 240 | 0.997 | 0.992 | 0.981 | 0.898 | 0.997 | 0.997 | 0.956 |
| 800 | 144 | 0.995 | 0.986 | 0.972 | 0.826 | 0.995 | 0.979 | 0.547 |
| 1200 | 96 | 1.000 | 0.985 | 0.963 | 0.627 | 0.999 | 0.779 | 0.284 |
數字是服務比例。本島三座閘道彼此只差 100~200 km,看得到的衛星幾乎相同,所以可見性上閘道數量不增加可用度;閘道的價值在地理與電力的獨立性,本模型看不到。
表 5:離軌與運作風險
| 高度 km | 自然衰減(低太陽活動)年 | 自然衰減(中)年 | 自然衰減(高)年 | 離軌 delta-V m/s | 離軌推進劑 kg | 每次發射顆數 |
|---|---|---|---|---|---|---|
| 550 | 13 | 5 | 2 | 143 | 9.6 | 9 |
| 800 | 477 | 191 | 76 | 208 | 13.8 | 7 |
| 1200 | — | — | — | 304 | 19.7 | 5 |
「—」表示超過 500 年。550 km 的自然衰減對太陽活動很敏感(2~13 年),不能只靠衰減離軌;800 km 以上必須主動離軌。
與既有 OneWeb(651 顆,1200 km、87.9°)的近距離事件(24 小時,篩選等級;模型誤差約 10~20 km,只適合比較相對風險):
| 高度 km | 星數 | < 10 km | < 25 km | < 50 km |
|---|---|---|---|---|
| 550 | 240 | 0 | 3 | 26 |
| 800 | 144 | 0 | 0 | 0 |
| 1200 | 96 | 214 | 1870 | 4787 |
做決策前應該先問的問題
- 需求是多少? 本摘要的 17.1 Gbps 是假設。容量、星數與成本都隨它變;先確定「斷纜時要保住哪些流量」。
- 服務等級要求是平均還是最差? 99% 的平均可用度與「任何時刻都不中斷」是兩個價錢。
- 軌道高度與現有殼層的關係。 成本最低的高度可能與既有星座重疊,交會迴避的營運成本沒有算進 TCO。
- 饋線頻譜取得得到嗎? 容量由它決定;頻譜與執照的取得時程與費用才是真正的不確定項。
- 成本參數換成實際報價後,敏感度排序是否改變? 龍捲風圖的前兩名是可以先去問價的項目。
本摘要沒有涵蓋的
- 終端設備的補貼與通路、頻譜與法規的法律意見、保險的實際承保條件。
- 1200 km 的輻射環境(范艾倫帶內帶邊緣)對衛星成本的影響。
- 閘道天線數與回傳線路的實際成本(只用同時服務衛星峰值 x 1.5 估天線數)。
- 備援價值本身(一天中斷的損失)—— 需要情境假設,本章刻意不估。
產生:python tw_brief.py。資料:results/*.csv。完整方法見 TaiwanLEO_Primer.md。
TaiwanLEO_Lab_Handout.md
實驗單 — 台灣自主低軌通訊衛星群的數位工程觀點
獨立章節,不屬於 16 週立方衛星課程。
先讀 TaiwanLEO_Primer.md;財務背景的讀者可直接讀 TaiwanLEO_Decision_Brief.md。
工具:Python(numpy、scipy、pandas、matplotlib、geopandas、sgp4、networkx)+ STK 13.1.0 桌面版(只用於交叉驗證)
資料:STK 安裝目錄附的海岸線(Data/Shapefiles/Countries/Taiwan);OneWeb 公開星曆(moda_satapp/tle/leo_oneweb.tce)
所有數字都是研究假設,不代表任何實際計畫。 這個實驗的重點是方法與驗證,
做的時候請一直問:我憑什麼相信這個結果是真的?
0. 情境
海纜中斷時,以規模受限的自主低軌星座,為下列區域提供備援通訊:
| 項目 | 設定 |
|---|---|
| 服務區 | 台灣本島、澎湖、金門、馬祖、東沙、太平島,自各島海岸向外 100 海浬(185.2 km) |
| 星座 | Walker delta,24~240 顆;高度 550 / 800 / 1200 km;傾角 25° / 53° / 70° / 太陽同步 |
| 使用者仰角門檻 | 25°(另掃 40°) |
| 閘道 | 本島東(花蓮)、西(台中)、南(屏東)各一座;仰角 10° |
| 架構 | 彎管;或具星間鏈路(ISL)的衛星比例 1/24、1/12、1/6(再加 1/3、1/2、全部) |
| 基準需求 | 14 個需求節點,共 17.1 Gbps(假設) |
| 成本 | 14 年 TCO(研發 3 + 部署 1 + 營運 10),低 / 基準 / 高三情境 |
1. 執行步驟
1.  開啟 STK 13.1.0 桌面版(只有第 5 步的交叉驗證需要)
2.  python tw_area.py                  服務區 + 兩種獨立算法驗證
3.  python tw_sweep.py --verify        涵蓋引擎:閉合式 + sgp4
4.  python tw_trade_coverage.py        第一輪掃描(固定 F=1)—— 看相位為什麼重要
5.  python tw_trade_walker_opt.py      最佳相位搜尋(含最小距離限制)
6.  python tw_stk_verify.py            STK 13.1.0 交叉驗證(需要 STK)
7.  python tw_link.py                  節 4:鏈路預算
8.  python tw_isl.py                   節 5:彎管 vs 再生式 + ISL
9.  python tw_capacity.py              節 6:容量
10. python tw_resilience.py            節 7:韌性
11. python tw_replenish.py             節 8:補網、衰減、離軌
12. python tw_ops.py                   節 9:換手、測控、避碰、對 OneWeb 的篩選
13. python tw_cost.py                  節 10:成本
14. python tw_brief.py                 產生決策摘要
15. python taiwanleo_verify.py         驗證段(兩層)
或一次跑完(數小時):python run_all.py;只跑部分:python run_all.py opt isl。
第 5 步最久(約 20 分鐘),第 12 步次之。
第一次一定會看到的現象
- 第 4 步的結果對 (P, F) 非常敏感,星數增加時可用度不單調(例如 192 顆的某設計勝過 240 顆的某設計)。這是真的,不是 bug,見導論 2.3。
- 第 5 步的輸出每一列有一欄
min_sep_km。請檢查沒有任何一列小於 20。 - 第 6 步需要約 10 分鐘,建 6 個 Walker 星座(最多 144 顆)。
2. 要回答的問題
2.1 服務區(節 1)
- 兩種算法(多邊形緩衝 vs 網格 + KD-tree)的面積差多少?逐點判定不一致的比例呢?
- 服務區面積約多少 km²?太平島佔多少?(提示:
results/service_grid.npz帶面積權重。) - 釣魚臺列嶼沒有納入,原因是什麼?改變這個假設會讓服務區多出多少?
2.2 涵蓋(節 2、3)
- 傾角 25° 與 53° 在同一高度、同樣星數下,涵蓋差多少?為什麼?
- 先看
coverage_sweep.csv(固定 F=1),再看walker_best.csv:同樣 240 顆、550 km、25°,兩者差多少?相位的影響比「多 50 顆」大還是小? - 把仰角門檻從 25° 改成 40°(
python tw_trade_walker_opt.py --el 40),達到 95% 所需的星數怎麼變?
2.3 反例:涵蓋最佳 ≠ 能飛(本章核心)
- 對照
walker_best_nosep.csv(無最小距離限制)與walker_best.csv:
- 有多少個設計因為限制而改變相位?涵蓋平均損失多少、最多損失多少?
- 找出一個無限制版本裡最小距離為 0 的設計,用tw_sep.py驗證。 - 用 STK 13.1.0 驗證:建該設計的 Walker 星座,取兩顆衛星用 Access 的
Range,最小距離是否也趨近 0?
(提示:STK 的衛星名是Seed<面 2 位數><顆 2 位數>,例如Seed0509。) - 為什麼涵蓋率驗證、STK 涵蓋交叉驗證、24 小時 vs 7 天一致,全都沒有攔下這個問題?
2.4 鏈路與星間鏈路(節 4、5)
- 同樣 25° 仰角,550 km 與 1200 km 的下行 SNR 差多少 dB?速率差多少?
- 在
tw_link.py的參數表裡,哪些參數是類別 A(假設)?把雨衰允許量從 3 dB 改成 6 dB,550 km 的速率怎麼變? - 為什麼只有太平島受架構影響?它距離台灣多遠?彎管衛星要同時滿足什麼條件?
- 具 ISL 的衛星比例從 1/24 增加到 1/6 到全部,太平島可用度怎麼變?是「門檻」還是「近乎線性」?為什麼?
2.5 容量與韌性(節 6、7)
- 容量上限是由波束還是饋線決定?把
FEEDER_BW_MHZ改成 4000,容量上限變多少?把BEAMS_PER_SAT改成 32 呢? - 為什麼
taiwanleo_verify.py檢查「容量上限 = 同時服務衛星數 × 饋線容量」時要容許 CSV 的四捨五入誤差? - 本島三座閘道失效一座、兩座,服務比例怎麼變?為什麼?這個結論不代表什麼?
- 使用者鏈路劣化 15 dB,550 km 與 1200 km 的服務比例各是多少?為什麼低軌更耐?
- 衛星失效 10% 時,平均服務比例與最差 5% 時刻的服務比例差多少?為什麼要同時看兩個?
2.6 補網、營運與成本(節 8~10)
- 550 km 的自然衰減壽命在低 / 中 / 高太陽活動下各是多少年?能不能只靠自然衰減離軌?
- 補網政策 A、B、C 的平均缺額差多少?為什麼 A 與 B 幾乎一樣?政策 C 多造的 12~16 顆值得嗎?(提示:接成本模型。)
- 本設計與 OneWeb 同殼層(1200 km)時,24 小時內 50 km 內的事件有多少?800 km 呢?這個數字的精確度如何?(提示:模型誤差約 10~20 km。)
- 找出滿足 99% 基準需求且 TCO 最低的設計。龍捲風圖的前三名參數是什麼?把它們換成「你問到的實際報價」,結論會變嗎?
- 第 22 題的最低成本設計,在營運面有什麼你不想要的性質?(提示:第 21 題。)
3. 驗證段
python taiwanleo_verify.py                  兩層都跑(約 5 分鐘)
python taiwanleo_verify.py --results-only   只檢查結果檔的關鍵斷言(幾秒)
第一層重跑各模組自己的驗證(閉合式、獨立實作、STK 13.1.0 對照)。
第二層讀 results/*.csv,確認章節的標題結論還成立。
為什麼要有第二層:各模組的驗證只保證「模型算對」,不保證「結果檔是用現在這版模型算的」。
這一章實際踩到的錯 —— 最佳相位表沒有最小距離限制就被下游使用 —— 是各模組的驗證都抓不到的。
練習: 把 results/walker_best.csv 換成 walker_best_nosep.csv(複製覆蓋),
重跑 taiwanleo_verify.py --results-only。哪一項會 FAIL?(這是失敗注入。做完請還原。)
4. 一直要問的問題
| 問題 | 本章的例子 |
|---|---|
| 這個結論通過了哪些檢查?那些檢查在檢查什麼? | 三個參考設計通過了所有涵蓋檢查,而最近距離是 0 |
| 比對的樣本有鑑別力嗎? | 三個設計的 STK 比對差 0.0003,因為都是 100% |
| 平均掩蓋了什麼? | 平均 99%,最差 5% 時刻 63% |
| 哪些數字是猜的? | 類別 A:需求、波束數、饋線頻寬、全部成本 |
| 最佳化的目標函數少寫了什麼? | 最小距離 |
| 這個數字的精確度夠回答這個問題嗎? | 對 OneWeb 的篩選,模型誤差 10~20 km |
5. 常見問題
| 現象 | 原因 |
|---|---|
SetState 被拒絕(NACK),半長軸給了 6928.137 |
STK 的 Connect 距離單位是工作階段狀態,可能已被改成公尺。先 Units_SetConnect / Distance km |
New / */Facility 台北 失敗 |
Connect 的物件名稱不能用中文,用 ASCII |
STK 的 ComputeAccess 成功但 Chain 沒有任何資料 |
STK 13 的 Chain 要 Connections.Add(從, 到, 1, 1) 並設 StartObject / EndObject |
import numba 失敗 |
numba 與新版 NumPy 不相容;本章不用 numba |
| STK 比對全部 0 差異 | 設計太飽和,沒有鑑別力。換可用度 40~90% 的設計 |
| 第 5 步很久 | 每個候選都要檢查星座內最小距離。可先用 --quick |
| 對 OneWeb 的事件數很大 | 同殼層時本來就多;見導論 8 節。這是篩選等級,不是交會評估 |
TaiwanLEO_Primer.md
基礎知識導論 — 台灣自主低軌通訊衛星群的數位工程觀點
本章是獨立章節,不屬於 16 週立方衛星課程。
它把前面學過的軌道、鏈路、營運與成本放進同一個系統設計問題:
一個規模受限的自主低軌通訊星群,在海纜中斷時能提供多少服務、要付出多少成本?這一章有一個反例貫穿全篇。
「涵蓋率最高的星座設計」是一個很容易得到、也會通過涵蓋計算的所有檢查的結論 ——
它是錯的:最佳相位常讓兩顆衛星在軌道面交點同時抵達,最近距離是 0 公尺。
第 3 節專門處理它,以及為什麼只看涵蓋率的最佳化會挑出這種設計。所有數字都是研究假設。 星座規模、需求、鏈路參數與成本都沒有任何一項代表實際計畫或廠商報價。
本章的價值在方法與結構:哪些因素驅動結果、結論對哪些假設敏感、每個結論怎麼被獨立驗證。
1. 這一章在解什麼問題
台灣對外的網路流量絕大部分走海底電纜。電纜中斷 —— 地震、船錨、蓄意破壞 —— 時,
本島與離島需要一條不依賴電纜的備援通訊。低軌衛星是候選之一。問題是:
- 服務區多大? 台灣本島、澎湖、金門、馬祖、東沙、太平島,以及各島海岸外 100 海浬的海域。
- 要多少顆衛星、飛多高? 小區域用低軌星座有個反直覺的性質,見第 3 節。
- 鏈路撐不撐得住? 用戶終端與閘道各要什麼規格。
- 星間鏈路(ISL)值不值得? 只有一部分衛星具備星間通訊(1/24、1/12、1/6)時,效果如何。
- 容量夠不夠? 17 Gbps 的備援需求,瓶頸是波束、饋線,還是閘道?
- 壞掉時還剩多少? 衛星失效、閘道失效、使用者鏈路被壓制。
- 怎麼補網、怎麼營運? 失效後多久補上、離軌、換手、測控、避碰。
- 要花多少錢? 給有意進入太空產業的財務長看的一節:區間而不是單點,以及哪些參數最敏感。
這章的受眾有兩種:學生要看方法與可重現的程式;財務長要看決策指標。
所以每一節開頭都有「給決策者的一頁」:結論、假設、風險,不需要軌道力學。
2. 核心觀念
2.1 「數位工程」在這裡的意思
不是軟體名詞,而是一條可追溯的線:
需求 → 模型 → 掃描 → 驗證 → 決策
- 每個結論回得到參數與程式:任何一個數字都能用同一份腳本重算。
- 每個模型附驗證:閉合式、第二套實作,或 STK 13.1.0 的獨立結果。
- 驗證要有鑑別力:第一輪 STK 比對三個設計差 0.0003,看起來完美 ——
但那三個設計幾乎都是 100%,沒有東西可以比。補上可用度只有 40~90% 的設計後,
才看到系統性差異(STK 比 Python 高約 0.5~1.2 個百分點)。會通過的檢查不一定在檢查東西。 - 假設要標類別:A 假設、B 典型量級、C 常數。財務長該知道哪些數字是猜的。
2.2 為什麼小區域需要很多顆衛星
全球星座(如數千顆)的設計目標是均勻覆蓋全球。台灣服務區只有約 67 萬 km²,
而一顆 550 km 的衛星同一時刻只看得到其中一小塊。每顆衛星大部分時間飛在服務區之外 ——
多數衛星在這個區域裡是閒置的。這是區域星座的核心成本結構:你為「覆蓋全球的軌道」付費,
卻只用到一小部分時間。
兩個影響這件事的設計旋鈕:
| 旋鈕 | 效果 |
|---|---|
| 傾角 | 服務區在北緯 10~27°。傾角 25° 的星座讓衛星集中在這個緯度帶;53°、70°、太陽同步則大量時間在別處 |
| 高度 | 越高,單顆衛星看得越大一塊(涵蓋率上升),但路徑損耗與延遲也增加 |
2.3 Walker 星座與「相位」
Walker delta 星座以 i: T/P/F 描述:T 顆衛星、P 個軌道面(RAAN 等間隔)、
相鄰軌道面的衛星相位差 F×360°/T。傾角 i、高度 h 決定「每顆衛星畫出的地面軌跡」,
(P, F) 決定這些軌跡怎麼互相交錯。對小區域,這比星數更重要:
- 同樣 240 顆、550 km、25°:某個 (P, F) 只有 85%,另一個 100%。
- 192 顆的好相位,可以勝過 240 顆的壞相位。
所以不能用「N 顆」比較,要用「最佳相位的 N 顆」比較 —— 這就是為什麼本章多做了一層最佳相位搜尋。
3. 反例:涵蓋最佳的星座,會讓衛星在軌道面交點相撞
最佳相位搜尋只看一個目標函數:服務區的涵蓋率。結果三個參考設計全部是 100% —— 而且
其中每一個,最近的一對衛星距離是 0 公尺(STK 獨立算:3.5 公尺)。
原因:兩個軌道面的 RAAN 相差 180° 時,它們的軌道在赤道的兩個節點相交。
若兩顆衛星的相位剛好讓它們同時抵達交點,就相撞。涵蓋最佳的 (P, F) 往往是高度對稱的,
而高度對稱正是同時抵達的條件。同高度、同傾角的 Walker,所有衛星的 J2 漂移率相同,
相對幾何每個軌道週期精確重複,所以不是「偶爾」,而是每一圈都發生。
為什麼沒有任何一項檢查攔下它:
| 檢查 | 為什麼沒攔住 |
|---|---|
| 涵蓋率驗證(閉合式、sgp4) | 它們驗的是「看得到嗎」,不是「會不會撞」 |
| STK 涵蓋交叉驗證 | 同上,而且那三個設計都是 100% |
| 24 小時與 7 天結果一致 | 一致只證明取樣沒問題,不證明設計能飛 |
這不是少數例外。 對全部 192 個「涵蓋最佳」的設計補算最小距離(tw_nosep_annotate.py),
有 94 個(49%)小於 20 km,其中 92 個小於 1 km。一半的「最佳」星座飛不了。
做法:把最小距離變成最佳化的限制。 本章用 20 km 作為門檻(A 假設):
低於這個值,軌道維持誤差就足以讓兩顆衛星相撞。加上限制後,96 組設計中 28 組的涵蓋下降,
最多 8 個百分點、平均不到 1 個百分點 —— 這是「能飛」的代價。
參考設計仍然約 100%,但其中一個的最小距離只有 27.6 km,是邊緣值。
這一節要帶走的:最佳化只會滿足你寫進去的目標。任何你沒寫成限制的物理條件,
最佳化都可能毫不留情地違反。
4. 鏈路預算(節 4)
鏈路預算的骨架:
C/N0 = EIRP − 路徑損耗 + G/T − k(= −228.6 dBW/K/Hz)
路徑損耗 = 自由空間 + 大氣 + 雨(允許量)+ 指向 + 極化
可達速率 = BW × 效率 × log2(1 + SNR / gap)
- 斜距決定自由空間損耗:550 km 的衛星,25° 仰角時斜距 1123 km,90° 時只有 550 km。
低仰角是最差情況,涵蓋門檻(25° 或 40°)直接決定鏈路餘裕。 - 高度的代價:同仰角下,1200 km 比 550 km 的 SNR 低約 6 dB,速率低約一半。
- 雨衰用固定允許量表示(Ku 3 dB、Ka 10 dB),是假設;STK 的 Comm 模組可算 ITU-R P.618。
- 上行與下行取較差者;本章下行是瓶頸。
- 最低仰角是成本驅動項。 使用者終端的最低仰角(25° 或 40°)同時決定涵蓋與鏈路餘裕。
傾角 25° 的星座要達到 95% 可用度:800 km 需 72 顆(25°)對 144 顆(40°),
1200 km 需 36 顆對 96 顆;550 km 在 25° 要 96 顆,在 40° 則 240 顆內達不到。
5. 星間鏈路與再生式酬載(節 5)
| 架構 | 使用者要服務,必須… |
|---|---|
| 彎管 | 有一顆衛星同時看得到使用者與某座境內閘道 |
| 再生式 + ISL(比例 f) | 連到任一顆可見衛星 S:S 自己看得到閘道,或 S 具 ISL 且經 ISL 網路到達看得到閘道的具 ISL 衛星 |
關鍵結果:只有太平島受影響。 太平島離台灣約 1700 km,彎管衛星要同時看到太平島與台灣的
閘道才行。其他地區的可用度,不管架構都接近 100%。
稀疏 ISL 效益很小。 在這個模型裡,使用者必須連到「具 ISL 的那顆衛星」才能繞出去,
所以太平島可用度大致是「涵蓋率 × 可見衛星剛好具 ISL 的機率」—— 近乎線性,不是門檻:
1/24、1/12、1/6 只多出零點幾到數個百分點,到「全部具備」才大幅改善。
更便宜的替代:把星座放高一點(800 km 時彎管讓太平島達 96~98%,1200 km 時達 100%)。
6. 容量(節 6)
容量由三個環節的最小值決定:
每顆衛星的服務能力 = min( 波束數 × 每波束速率, 饋線容量 )
在本章假設下(16 個波束、1 GHz/波束、饋線 2 GHz),瓶頸是饋線,不是使用者波束:
容量上限剛好等於「同時服務的衛星數 × 9 Gbps」。敏感度:
- 饋線頻寬翻倍,容量幾乎翻倍。
- 每星波束數 16 vs 32 沒有差別(8 個才會拖累)。
所以「多買一倍饋線頻譜」與「多一倍衛星」在容量上近乎等價 —— 成本節要比較的核心。
平均不是服務等級。 最差 5% 的時刻比平均差很多:某設計平均 38%,最差 5% 時刻是 0%。
7. 韌性(節 7)—— 只做抽象的可用度分析
| 情境 | 結果的形狀 |
|---|---|
| 衛星隨機失效 | 失效 10% 時平均服務比例掉 2~4 個百分點,最差 5% 時刻只剩 63~90% |
| 閘道失效 | 本島三座閘道彼此只差 100~200 km,任一座看得到的衛星幾乎一樣 —— 閘道數量不增加可用度,全部同時失效則歸零 |
| 使用者鏈路被壓制(抽象為額外損耗) | 低軌更耐:550 km 吃得下 15 dB,1200 km 在 15 dB 就掉到約 78% |
閘道的意義不是可見性,而是地理與電力的獨立性(颱風、地震不會同時打到所有站)。
本章的可用度模型看不到這件事,所以第 7 節的結論是「可見性上沒有差別」,不是「閘道多寡無關緊要」。
8. 補網、離軌與營運(節 8、9)
- 失效與補網:設計壽命 5 年、存活率 90%、部署即失效 2%。補網延遲 6 個月時,平均缺額約 1%。
每年需補造約 20~50 顆衛星(視星座規模),每年 4~6 次發射。 - 離軌:550 km 自然衰減約 5 年(太陽活動中等),低太陽活動時 13 年,不能只靠衰減;
800 km 約 190 年、1200 km 實質上不衰減,都要主動離軌(delta-V 約 140~300 m/s,推進劑 10~20 kg)。 - 換手:本島的使用者終端每小時換手約 8~27 次(高度越低越頻繁)。
- 測控:兩站(台北、屏東)每顆衛星每天約 6~7 次接觸,每次 8~14 分鐘;
同一站同時在視的衛星數峰值 7~9 顆,決定天線數。 - 對既有星座的交會:本星座與 OneWeb(1200 km、87.9°)同一高度殼層時,
24 小時內 50 km 以內的近距離事件約 4800 件(篩選等級);800 km 或 550 km 幾乎沒有。
選高度不只是工程與成本問題,也是軌道環境問題。
9. 成本(節 10)—— 給財務長
總擁有成本(TCO)= 研發 3 年 + 部署 1 年 + 營運 10 年,含補網。三個原則:
- 用區間,不用單點。 每個參數給低 / 基準 / 高,另外用蒙地卡羅給 P10~P90。
- 每個參數標類別。 全部是 A(假設),沒有任何報價。
- 看結構,不看絕對數字。 驅動成本的是哪些項目、哪些參數最敏感。
結構上的觀察:營運期的補網(衛星 + 發射 + 保險)佔總成本的 54~58% —— 這是「衛星壽命有限」的直接後果,
也是財務長最容易低估的一項。最敏感的參數是第一顆衛星的量產成本與每次發射單價,
研發 NRE 與地面段反而影響不大。
10. 這一章的方法論清單
| 做法 | 為什麼 |
|---|---|
| 兩種獨立算法驗證服務區 | 面積差 0.22%,逐點不一致 0.065% |
| 涵蓋引擎對閉合式與 sgp4 | 閉合式差 0.02%,sgp4 逐點一致 99.84% |
| 用 STK 13.1.0 交叉驗證,且挑有鑑別力的設計 | 飽和的設計比不出差異 |
| 最佳化加物理限制(最小距離) | 只看涵蓋率會挑出相撞的星座 |
| 24 小時 vs 7 天一致 | 排除取樣假象;但不證明可飛 |
| 假設標類別 A / B / C | 讓財務長知道哪些是猜的 |
| 平均與最差 5% 時刻並列 | 平均會掩蓋服務中斷 |
| 成本只給區間 | 避免被誤讀成預算 |
11. 常見陷阱(本章實際踩到的)
- 最佳涵蓋 ≠ 能飛。 最小距離 0 公尺的星座通過了所有涵蓋檢查。
- STK 的 Connect 距離單位是工作階段狀態。 同一個 STK 被腳本改成公尺後,半長軸填 6928.137 會被當成 6.9 公尺而被拒絕。每次先
Units_SetConnect / Distance km。 - Connect 的物件名稱不能用中文。
New / */Facility 台北會失敗,用 ASCII。 - STK 13 的 Chain 不能只
Add物件。 要Connections.Add(從, 到, 最少, 最多)並設StartObject/EndObject,否則ComputeAccess成功但結果為空,不報錯。 - numba 與新版 NumPy 不相容。 用矩陣乘法取代逐點迴圈,速度夠用。
- 取樣步長決定你看不看得到最近點。 相對速度約 14 km/s,1 秒的步長是 14 km 的盲區;最近點要用連續最小化精修。
- 飽和的設計比不出差異。 比對要挑可用度在 40~90% 的設計。
- ISL 比例的改善近乎線性,不是門檻。 不要預設「稀疏骨幹」會有拐點。
- 衰減壽命對太陽活動極敏感。 550 km 從 2 年到 13 年都有可能,不能只算一個數字。
12. 先修與延伸
- 先修:Week 4(軌道設計)、Week 11(通訊鏈路)、Week 14(運作)。
- 延伸:獨立章節 3(雙節運載火箭與交會迴避)、獨立章節 4(TIREM 地形傳播)、
moda_satapp/(七個場景)。
圖

taiwan_leo_constellation/results/capacity.png
taiwan_leo_constellation/results/cost.png

taiwan_leo_constellation/results/coverage_vs_N.png
taiwan_leo_constellation/results/resilience.png
程式碼
# -*- coding: utf-8 -*-
r"""依序重跑本章所有計算(含最小距離限制的最佳相位搜尋,以及下游每一步)。

    python run_all.py            # 全部(數小時)
    python run_all.py opt isl    # 只跑指定步驟

每一步都先跑自己的驗證段;任何一步驗證失敗就停止。
"""
import subprocess
import sys
import time

STEPS = [
    ("opt", ["tw_trade_walker_opt.py"]),
    ("plot1", ["tw_plots.py"]),
    ("isl", ["tw_isl.py"]),
    ("knee", ["tw_isl_knee.py"]),
    ("capacity", ["tw_capacity.py"]),
    ("capsens", ["tw_capacity_sens.py"]),
    ("degr", ["tw_degradation_curve.py"]),
    ("resil", ["tw_resilience.py"]),
    ("resilgw", ["tw_resilience_gw.py"]),
    ("plot2", ["tw_plots2.py"]),
    ("replenish", ["tw_replenish.py"]),
    ("ops", ["tw_ops.py"]),
    ("opt40", ["tw_trade_walker_opt.py", "--el", "40"]),
]


def main(argv):
    want = set(argv) or {k for k, _ in STEPS}
    t0 = time.time()
    for key, cmd in STEPS:
        if key not in want:
            continue
        print("[%5.0f s] === %s ===" % (time.time() - t0, key), flush=True)
        r = subprocess.run([sys.executable] + cmd)
        if r.returncode != 0:
            print("步驟 %s 失敗(離開碼 %d),停止。" % (key, r.returncode), flush=True)
            return r.returncode
    print("[%5.0f s] 全部完成" % (time.time() - t0), flush=True)
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
# ================================================================
# taiwanleo_verify.py — 獨立章節 8 的驗證段
#
# 兩層:
#   (1) 各模組自己的驗證(閉合式、獨立實作、STK 13.1.0 對照)—— 重新執行
#   (2) 結果檔的關鍵斷言 —— 讀 results/*.csv,檢查章節的標題結論還成立
#
# 為什麼要有第二層:各模組驗證只保證「模型算對」,不保證「結果檔是用現在這版模型算的」。
# 結果檔過期(例如最佳相位沒加最小距離限制就拿去用)是這章實際踩到的錯,
# 而且各模組的驗證都不會抓到。
#
#   python taiwanleo_verify.py                 # 兩層都跑(約 5 分鐘)
#   python taiwanleo_verify.py --results-only  # 只跑第二層(幾秒)
#   離開碼 0 = 全部通過,1 = 有項目對不上
# ================================================================
import io
import os
import sys

import numpy as np
import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
REPO = os.path.abspath(os.path.join(HERE, os.pardir))
sys.path.insert(0, HERE)
sys.path.insert(0, os.path.join(REPO, "tools"))
from stk_verify import Verifier        # noqa: E402

R = os.path.join(HERE, "results")


def module_checks(v):
    import tw_capacity, tw_cost, tw_isl, tw_link, tw_ops, tw_replenish, tw_resilience, tw_sweep
    for name, fn in (("涵蓋引擎(閉合式 + sgp4)", lambda: tw_sweep.verify_closed_form() and tw_sweep.verify_sgp4()),
                     ("鏈路預算", tw_link.verify), ("星間鏈路與架構比較", tw_isl.verify),
                     ("容量", tw_capacity.verify), ("韌性", tw_resilience.verify),
                     ("補網、衰減與離軌", tw_replenish.verify), ("營運", tw_ops.verify), ("成本", tw_cost.verify)):
        print("\n--- %s ---" % name)
        v.expect_true("模組驗證:" + name, bool(fn()))


def result_checks(v):
    # 服務區
    import json
    gj = json.load(io.open(os.path.join(R, "service_area.geojson"), encoding="utf-8"))
    npz = np.load(os.path.join(R, "service_grid.npz"))
    area = float(npz["w"].sum())
    v.expect_between("服務區面積(km²,網格法)", area, 650000, 690000, " km²")
    v.expect_true("服務區 GeoJSON 的緩衝 = 185.2 km(100 海浬)", abs(gj["properties"]["buffer_km"] - 185.2) < 1e-6)

    # 最佳相位:每一列都滿足最小距離限制(本章的核心反例)
    wb = pd.read_csv(os.path.join(R, "walker_best.csv"))
    ok_rows = wb.dropna(subset=["avail"])
    v.expect_true("最佳相位表每一列的衛星間最近距離 >= 20 km",
                  bool((ok_rows.min_sep_km >= 20.0).all()),
                  "最小 %.1f km,共 %d 列" % (ok_rows.min_sep_km.min(), len(ok_rows)))
    nosep = pd.read_csv(os.path.join(R, "walker_best_nosep.csv"))
    v.expect_true("有保留「無最小距離限制」的對照結果", len(nosep) == len(wb))
    m = ok_rows[ok_rows.limit == "practical"].merge(nosep[nosep.limit == "practical"],
                                                   on=["N", "h_km", "inc_label", "el_deg", "limit"], suffixes=("", "_ns"))
    # 最佳相位搜尋是啟發式(篩選前幾名再精算),加限制後挑到的候選偶爾反而略好,所以容許 0.01 的搜尋誤差
    v.expect_true("加限制後涵蓋不會比無限制更好超過 0.01(啟發式搜尋誤差)", bool((m.avail <= m.avail_ns + 0.01).all()),
                  "最大 +%.4f" % (m.avail - m.avail_ns).max())
    v.expect_true("加限制的涵蓋損失:平均 < 0.02、最大 < 0.10", float((m.avail_ns - m.avail).mean()) < 0.02
                  and float((m.avail_ns - m.avail).max()) < 0.10,
                  "平均 %.4f、最大 %.4f" % ((m.avail_ns - m.avail).mean(), (m.avail_ns - m.avail).max()))
    if "min_sep_km" in nosep.columns:
        frac_bad = float((nosep.min_sep_km < 20.0).mean())
        v.expect_true("反例的證據:無限制的最佳相位表有相當比例飛不了(最近距離 < 20 km 佔 >= 30%)", frac_bad >= 0.30,
                      "佔 %.0f%%(%d / %d)" % (100 * frac_bad, int((nosep.min_sep_km < 20.0).sum()), len(nosep)))
    refs = [(550.0, 240), (800.0, 144), (1200.0, 96)]
    for h, N in refs:
        r = ok_rows[(ok_rows.limit == "practical") & (ok_rows.inc_label == "25") & (ok_rows.el_deg == 25.0)
                    & (ok_rows.h_km == h) & (ok_rows.N == N)].iloc[0]
        v.expect_true("參考設計 %.0f km / %d 顆:涵蓋 >= 0.99 且軌道面數 <= 24" % (h, N),
                      r.avail >= 0.99 and r.P <= 24, "avail %.4f、P=%d、F=%d、最近距離 %.1f km" % (r.avail, r.P, r.F, r.min_sep_km))

    # 仰角門檻:40° 所需的星數不少於 25°(越高的門檻越難涵蓋)
    w40 = pd.read_csv(os.path.join(R, "walker_best_el40.csv")).dropna(subset=["avail"])
    p25 = ok_rows[(ok_rows.limit == "practical")]
    p40 = w40[w40.limit == "practical"]
    mm = p25.merge(p40, on=["N", "h_km", "inc_label", "limit"], suffixes=("_25", "_40"))
    v.expect_true("同一設計在 40° 的涵蓋不會比 25° 好(容許 0.01 的搜尋誤差)", bool((mm.avail_40 <= mm.avail_25 + 0.01).all()),
                  "最大 +%.4f(%d 組)" % ((mm.avail_40 - mm.avail_25).max(), len(mm)))
    v.expect_true("40° 的最佳相位表也滿足最近距離 >= 20 km", bool((w40.min_sep_km >= 20.0).all()))

    # STK 交叉驗證:要有鑑別力(未飽和的點夠多)
    st = pd.read_csv(os.path.join(R, "stk_crosscheck.csv"))
    uns = st[st.avail_py < 0.995]
    v.expect_true("STK 對 Python:42 個比對點最大差 <= 0.03", st["diff"].abs().max() <= 0.03,
                  "最大 %.4f" % st["diff"].abs().max())
    v.expect_true("STK 比對有鑑別力:未飽和(< 0.995)的點 >= 15 個", len(uns) >= 15, "%d 個" % len(uns))

    # 容量:瓶頸是饋線
    cap = pd.read_csv(os.path.join(R, "capacity.csv"))
    cap = cap[cap.weather == "晴"]
    bound = cap.nsat_serving * cap.feeder_cap_gbps
    rel = (bound - cap.capacity_ceiling_gbps).abs() / bound
    tol = 0.05 / cap.nsat_serving + 0.005             # 結果檔把 nsat_serving 四捨五入到 0.1,小值的相對誤差大
    v.expect_true("容量上限 = 同時服務衛星數 x 饋線容量(饋線是瓶頸;容許 CSV 四捨五入誤差)",
                  bool((rel <= tol).all()), "最大相對差 %.4f(最大容許 %.4f)" % (rel.max(), tol.max()))

    # 星間鏈路:巢狀單調與稀疏 ISL 效益
    isl = pd.read_csv(os.path.join(R, "isl_trade.csv"))
    mono = True
    for (h, N), g in isl.groupby(["h_km", "N"]):
        seq = g.set_index("f_den").loc[[0, 24, 12, 6, 1]].avail_mean.values
        mono &= bool(np.all(np.diff(seq) >= -1e-9))
    v.expect_true("ISL 比例越高可用度不減(18 個設計)", mono)

    # 成本
    d = pd.read_csv(os.path.join(R, "cost_designs.csv"))
    v.expect_true("TCO 低 <= 基準 <= 高(所有設計)", bool(((d.tco_low <= d.tco_base) & (d.tco_base <= d.tco_high)).all()))
    v.expect_true("蒙地卡羅 P10 <= P50 <= P90", bool(((d.tco_mc_p10 <= d.tco_mc_p50) & (d.tco_mc_p50 <= d.tco_mc_p90)).all()))
    one = d[d.h_km == 800.0].sort_values("N")
    v.expect_true("同高度下,星數越多 TCO 越高", bool(np.all(np.diff(one.tco_base.values) > 0)))

    # 運作:既有星座的交會
    ow = pd.read_csv(os.path.join(R, "ops_oneweb.csv")).set_index("h_km")
    v.expect_true("與 OneWeb 同殼層(1200 km)的 50 km 事件數 > 其他高度的 100 倍",
                  ow.loc[1200.0].lt50km > 100 * max(1, ow.loc[550.0].lt50km, ow.loc[800.0].lt50km),
                  "1200 km: %d;550 km: %d;800 km: %d" % (ow.loc[1200.0].lt50km, ow.loc[550.0].lt50km, ow.loc[800.0].lt50km))
    sep = pd.read_csv(os.path.join(R, "ops_separation.csv"))
    v.expect_true("營運段回報的參考設計最近距離都 >= 20 km", bool((sep.min_sep_km >= 20.0).all()),
                  "最小 %.1f km" % sep.min_sep_km.min())


def main(argv):
    v = Verifier(None)
    if "--results-only" not in argv:
        module_checks(v)
    print("\n--- 結果檔的關鍵斷言 ---")
    result_checks(v)
    ok = v.report("獨立章節 8 驗證段")
    return 0 if ok else 1


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""服務區:台灣各島海岸向外 100 海浬(185.2 km)。

    python tw_area.py            # 產生 results/service_area.geojson、service_grid.npz、驗證

## 資料來源與假設

- 本島、澎湖、金門、蘭嶼、綠島等:STK 13 安裝目錄附的 `Data/Shapefiles/Countries/Taiwan`(8 個部分)。
  解析度粗(本島 406 點),對 185 km 的緩衝影響可忽略。
- 該檔缺少的離島以**近似座標**補上(公開常見座標,單位度,誤差約 0.01~0.05 度,
  對 185 km 的緩衝可忽略):馬祖、烏坵、東沙、太平島、彭佳嶼與棉花嶼。
  釣魚臺列嶼主權有爭議,**不納入**。
- 100 海浬 = 185.2 km,量法為「自各島海岸」,不是自領海基線。

## 兩種獨立算法互相驗證

A. 多邊形法:每個島在以自身為中心的方位等距投影下做 185.2 km 緩衝,再聯集。
B. 網格法:海岸線加密成點,對每個網格點用 KD-tree 找最近海岸點的弦距,轉成大圓距離判斷。
兩者面積應相差 < 1%,逐點判定不一致的比例應 < 1%。
"""
import io
import json
import os

import numpy as np

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")
STK_SHP = "C:/Program Files/AGI/STK_ODTK 13/Data/Shapefiles/Countries/Taiwan/Taiwan.shp"

R_EARTH_KM = 6371.0088          # 球面近似;對 185 km 的距離誤差 < 0.3%
BUFFER_KM = 100 * 1.852         # 100 海浬

# STK 的 Taiwan 檔沒有的離島(近似座標,度)。釣魚臺列嶼不納入。
EXTRA_ISLANDS = [
    ("馬祖(南竿)", 26.16, 119.95),
    ("烏坵", 24.99, 119.45),
    ("東沙", 20.70, 116.72),
    ("太平島", 10.38, 114.36),
    ("彭佳嶼", 25.63, 122.08),
    ("棉花嶼", 25.48, 122.11),
]


def load_islands():
    """[(名稱, shapely 多邊形或點), ...]。"""
    import geopandas as gpd
    from shapely.geometry import Point
    g = gpd.read_file(STK_SHP)
    geom = g.geometry.iloc[0]
    parts = sorted(geom.geoms, key=lambda p: -p.area)
    out = []
    for i, p in enumerate(parts):
        c = p.centroid
        out.append(("STK-%d(%.2fN,%.2fE)" % (i + 1, c.y, c.x), p))
    for name, lat, lon in EXTRA_ISLANDS:
        out.append((name, Point(lon, lat)))
    return out


def aeqd_buffer(shape, km):
    """方位等距投影下對單一島緩衝,回傳經緯度多邊形。"""
    import pyproj
    from shapely.ops import transform
    c = shape.centroid
    crs = pyproj.CRS.from_proj4("+proj=aeqd +lat_0=%.6f +lon_0=%.6f +datum=WGS84 +units=m" % (c.y, c.x))
    to_xy = pyproj.Transformer.from_crs("EPSG:4326", crs, always_xy=True).transform
    to_ll = pyproj.Transformer.from_crs(crs, "EPSG:4326", always_xy=True).transform
    buf = transform(to_xy, shape).buffer(km * 1000.0, 64)
    return transform(to_ll, buf)


def service_polygon(km=BUFFER_KM):
    """A. 多邊形法:各島緩衝聯集。回傳 (聯集, 各島清單)。"""
    from shapely.ops import unary_union
    islands = load_islands()
    return unary_union([aeqd_buffer(s, km) for _n, s in islands]), islands


def coast_points(islands, step_km=2.0):
    """B 法用:把各島海岸線加密成點(經緯度)。"""
    from shapely.geometry import Point, Polygon, MultiPolygon
    pts = []
    for _n, s in islands:
        if isinstance(s, Point):
            pts.append((s.x, s.y))
            continue
        polys = s.geoms if isinstance(s, MultiPolygon) else [s]
        for p in polys:
            ring = np.asarray(p.exterior.coords)
            for a, b in zip(ring[:-1], ring[1:]):
                d = np.hypot((b[0] - a[0]) * np.cos(np.radians(a[1])), b[1] - a[1]) * 111.19
                n = max(2, int(d / step_km) + 1)
                t = np.linspace(0, 1, n, endpoint=False)
                pts += list(zip(a[0] + t * (b[0] - a[0]), a[1] + t * (b[1] - a[1])))
    return np.array(pts)


def ecef_unit(lat, lon):
    lat, lon = np.radians(lat), np.radians(lon)
    return np.stack([np.cos(lat) * np.cos(lon), np.cos(lat) * np.sin(lon), np.sin(lat)], axis=-1)


def within_km_grid(lat, lon, coast_ll, km=BUFFER_KM):
    """B. 網格法:到最近海岸點的大圓距離 <= km。"""
    from scipy.spatial import cKDTree
    tree = cKDTree(ecef_unit(coast_ll[:, 1], coast_ll[:, 0]))
    d_chord, _ = tree.query(ecef_unit(lat, lon))
    d_km = 2.0 * R_EARTH_KM * np.arcsin(np.clip(d_chord / 2.0, 0, 1))
    return d_km <= km, d_km


def make_grid(step_deg=0.1, box=(8.0, 28.0, 112.0, 125.0)):
    la = np.arange(box[0], box[1] + 1e-9, step_deg)
    lo = np.arange(box[2], box[3] + 1e-9, step_deg)
    LO, LA = np.meshgrid(lo, la)
    return LA.ravel(), LO.ravel()


def cell_area_km2(lat, step_deg):
    return (np.radians(step_deg) * R_EARTH_KM) ** 2 * np.cos(np.radians(lat))


def main():
    from shapely.geometry import Point, mapping
    os.makedirs(RES, exist_ok=True)
    poly, islands = service_polygon()
    coast = coast_points(islands)
    lat, lon = make_grid(0.1)
    inB, dist = within_km_grid(lat, lon, coast)
    inA = np.array([poly.contains(Point(x, y)) for x, y in zip(lon, lat)])
    area = cell_area_km2(lat, 0.1)
    aA, aB = float(area[inA].sum()), float(area[inB].sum())
    mism = float(np.mean(inA != inB))
    print("島嶼 %d 個(STK %d + 補充 %d),海岸點 %d" % (
        len(islands), len(islands) - len(EXTRA_ISLANDS), len(EXTRA_ISLANDS), len(coast)))
    print("A 多邊形法面積 %.0f km2   B 網格法面積 %.0f km2   差 %.2f%%" % (aA, aB, 100 * abs(aA - aB) / aB))
    print("逐點判定不一致 %.3f%%(網格 %d 點)" % (100 * mism, len(lat)))
    ok = abs(aA - aB) / aB < 0.01 and mism < 0.01
    print("驗證:%s" % ("PASS" if ok else "FAIL"))

    json.dump({"type": "Feature", "properties": {"buffer_km": BUFFER_KM, "basis": "各島海岸"},
               "geometry": mapping(poly)},
              io.open(os.path.join(RES, "service_area.geojson"), "w", encoding="utf-8"))
    # 服務區網格(0.25 度,供星座掃描用):取 B 法判定,附面積權重
    la2, lo2 = make_grid(0.25)
    in2, _ = within_km_grid(la2, lo2, coast)
    np.savez(os.path.join(RES, "service_grid.npz"), lat=la2[in2], lon=lo2[in2],
             w=cell_area_km2(la2[in2], 0.25), step=0.25)
    print("服務區網格 %d 點(0.25 度),總面積 %.0f km2" % (in2.sum(), cell_area_km2(la2[in2], 0.25).sum()))
    return 0 if ok else 1


if __name__ == "__main__":
    raise SystemExit(main())
# -*- coding: utf-8 -*-
r"""由 results/*.csv 產生「給財務長的決策摘要」與成本圖。
python tw_brief.py # -> TaiwanLEO_Decision_Brief.md、results/cost.png
文中所有數字與表格都由結果檔算出來,不手抄 —— 手抄的數字會在重跑之後默默過期。
敘述中的斷言(例如「最便宜且滿足 99% 的是哪一個設計」)同樣由資料決定。
"""
import io
import os
import sys
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
HERE = os.path.dirname(os.path.abspath(__file__))
R = os.path.join(HERE, "results")
sys.path.insert(0, os.path.join(HERE, os.pardir, "tools"))
from cjk import use_cjk # noqa: E402
use_cjk()
COL = {550.0: "#1b6ca8", 800.0: "#d1802b", 1200.0: "#6a8e3a"}
DEMAND_BASE = 17.1
def md_table(df, fmt=None):
fmt = fmt or {}
cols = list(df.columns)
out = ["| " + " | ".join(cols) + " |", "|" + "---|" * len(cols)]
for _i, r in df.iterrows():
out.append("| " + " | ".join(fmt.get(c, str)(r[c]) for c in cols) + " |")
return "\n".join(out)
def plot_cost(d):
fig, ax = plt.subplots(figsize=(8.5, 5))
for h, g in d.groupby("h_km"):
g = g.sort_values("N")
x = g.frac_base * 100
ax.errorbar(x, g.tco_base / 1000, yerr=[(g.tco_base - g.tco_low) / 1000, (g.tco_high - g.tco_base) / 1000],
fmt="o-", color=COL[h], capsize=3, label="%.0f km" % h, alpha=0.9)
for _i, r in g.iterrows():
ax.annotate(str(int(r.N)), (r.frac_base * 100, r.tco_base / 1000), textcoords="offset points",
xytext=(4, 5), fontsize=7, color=COL[h])
ax.axvline(99, color="#999", ls="--", lw=0.8)
ax.set_yscale("log")
ax.set_xlabel("基準需求(%.1f Gbps)被滿足的比例(%%)" % DEMAND_BASE)
ax.set_ylabel("14 年總擁有成本(十億美元,對數軸)")
ax.set_title("服務比例對成本:點為基準,誤差線為低 / 高情境;數字是星數")
ax.grid(alpha=0.3, which="both")
ax.legend()
fig.tight_layout()
fig.savefig(os.path.join(R, "cost.png"), dpi=140)
def main():
d = pd.read_csv(os.path.join(R, "cost_designs.csv"))
tor = pd.read_csv(os.path.join(R, "cost_tornado.csv"))
isl = pd.read_csv(os.path.join(R, "cost_isl.csv"))
res = pd.read_csv(os.path.join(R, "resilience.csv"))
ops_ow = pd.read_csv(os.path.join(R, "ops_oneweb.csv"))
dec = pd.read_csv(os.path.join(R, "decay_deorbit.csv"))
plot_cost(d)
ok99 = d[d.frac_base >= 0.99].sort_values("tco_base")
best = ok99.iloc[0]
cheapest_each_h = {h: g[g.frac_base >= 0.99].sort_values("tco_base").head(1) for h, g in d.groupby("h_km")}
ow = ops_ow.set_index("h_km")
fmt0 = lambda x: "%.0f" % float(x) # noqa: E731
L = []
L.append("# 給財務長的決策摘要 — 台灣自主低軌通訊衛星群")
L.append("")
L.append("> **先讀這段。** 本摘要的所有數字都是**研究假設**(類別 A),沒有任何一項來自特定計畫或廠商報價,"
"也不是投資建議。價值在結構:哪些項目驅動成本、成本對哪些參數敏感、哪些結論經過獨立驗證。"
"使用前請以實際報價取代成本參數。金額單位:百萬美元(M USD),未換算匯率。")
L.append("")
L.append("## 一頁結論")
L.append("")
L.append("**問題:** 海纜中斷時,以規模受限的自主低軌星座提供台灣本島、離島與 100 海浬海域的備援通訊,"
"能提供多少服務、要付出多少成本?(基準需求 %.1f Gbps,為假設。)" % DEMAND_BASE)
L.append("")
L.append("1. **能滿足基準需求 99%% 以上、且 14 年總成本最低的設計:%.0f km、%d 顆**,基準 TCO 約 **%s M USD**"
"(低 / 高情境 %s ~ %s;蒙地卡羅 P10~P90 %s ~ %s)。"
% (best.h_km, best.N, fmt0(best.tco_base), fmt0(best.tco_low), fmt0(best.tco_high),
fmt0(best.tco_mc_p10), fmt0(best.tco_mc_p90)))
ow_best = ow.loc[best.h_km] if best.h_km in ow.index else None
if ow_best is not None and int(ow_best.lt50km) > 100:
L.append(" - **但這個高度與既有的 OneWeb 星座在同一個殼層**:24 小時內與 OneWeb 近距離(50 km 內)事件約 %d 件"
"(篩選等級)。成本最低不等於可行 —— 交會迴避的運作負擔與風險沒有算進 TCO。" % int(ow_best.lt50km))
L.append("2. **成本對兩個參數最敏感:%s 與 %s**(龍捲風圖第一、第二)。研發、地面段與人力不是主要因素。"
% (tor.iloc[0].desc, tor.iloc[1].desc))
import tw_cost as K
dd = {"h": float(best.h_km), "N": int(best.N), "n_isl": 0, "antennas_peak": int(best.antennas_peak)}
shares = []
for w in ("low", "base", "high"):
t = K.tco(dd, K.pick(w))
rep = sum(v for k, v in t["items"].items() if k.startswith("營運 10 年:補網"))
shares.append(100 * rep / t["total"])
L.append("3. **營運期的補網(衛星 + 發射 + 保險)佔總成本 %.0f~%.0f%%**:衛星有壽命,星座要持續補造。"
"這是財務模型最容易低估的一項。" % (min(shares), max(shares)))
L.append("4. **容量由衛星的饋線頻寬決定,不是使用者波束。** 饋線頻寬翻倍,容量幾乎翻倍;"
"「買一倍饋線頻譜」與「多一倍衛星」在容量上近乎等價,成本差別很大 —— 值得優先比較。")
L.append("5. **星間鏈路 + 再生式只對太平島有意義**,而且只在全部衛星都具備時才大幅改善;"
"稀疏的 1/24、1/12、1/6 效益很小,到 1/6 也只多出數個百分點(見表 3)。較高的軌道高度能用更低的成本達到類似效果。")
r10 = []
for (h, N), g in res.groupby(["h_km", "N"]):
if not g.scenario.eq("S0").any():
continue
base_v = float(g[g.scenario == "S0"].frac_mean.iloc[0])
x = g[(g.scenario == "S1") & g.detail.str.contains("失效 10%", regex=False) & ~g.detail.str.contains("最差")].iloc[0]
r10.append((100 * (base_v - float(x.frac_mean)), 100 * float(x.frac_p05)))
L.append("6. **平均服務比例會掩蓋中斷。** 衛星失效 10%% 時,平均只掉 %.0f~%.0f 個百分點,但最差 5%% 時刻的服務比例只剩 %.0f~%.0f%%。"
% (min(a for a, _b in r10), max(a for a, _b in r10), min(b for _a, b in r10), max(b for _a, b in r10)))
L.append("")
L.append("## 圖:服務比例對成本")
L.append("")
L.append("")
L.append("")
L.append("## 表 1:設計選項(傾角 25°,最佳相位且衛星間最近距離 ≥ 20 km)")
L.append("")
t1 = d[["h_km", "N", "frac_base", "frac_base_p05", "ceiling_gbps", "tco_low", "tco_base", "tco_high",
"tco_mc_p10", "tco_mc_p90", "annualized_musd", "usd_per_gb"]].copy()
t1.columns = ["高度 km", "星數", "服務比例", "服務比例(最差 5%)", "容量上限 Gbps", "TCO 低", "TCO 基準", "TCO 高",
"MC P10", "MC P90", "年化 M USD", "每 GB(USD)"]
L.append(md_table(t1, {"高度 km": fmt0, "星數": fmt0, "服務比例": lambda x: "%.3f" % x,
"服務比例(最差 5%)": lambda x: "%.3f" % x, "容量上限 Gbps": lambda x: "%.1f" % x,
"TCO 低": fmt0, "TCO 基準": fmt0, "TCO 高": fmt0, "MC P10": fmt0, "MC P90": fmt0,
"年化 M USD": lambda x: "%.0f" % x, "每 GB(USD)": lambda x: "%.2f" % x}))
L.append("")
L.append("")
L.append("### 表 1b:使用者終端最低仰角對所需星數的影響(傾角 25°,最佳相位且最近距離 ≥ 20 km)")
L.append("")
w25 = pd.read_csv(os.path.join(R, "walker_best.csv"))
w40 = pd.read_csv(os.path.join(R, "walker_best_el40.csv"))
def thr(df, h, t):
g = df[(df.limit == "practical") & (df.inc_label.astype(str) == "25") & (df.h_km == h) & df.avail.notna() & (df.avail >= t)]
return "%d" % g.N.min() if len(g) else "> 240"
t1b = pd.DataFrame([[h, thr(w25, h, 0.95), thr(w25, h, 0.99), thr(w40, h, 0.95), thr(w40, h, 0.99)]
for h in (550.0, 800.0, 1200.0)],
columns=["高度 km", "25° 達 95%", "25° 達 99%", "40° 達 95%", "40° 達 99%"])
L.append(md_table(t1b, {"高度 km": fmt0}))
L.append("")
L.append("數字是所需的最少衛星數(掃描範圍 24~240 顆;「> 240」表示範圍內達不到)。"
"**終端的最低仰角是主要的成本驅動項**:門檻從 25° 提到 40°,所需星數大幅增加。")
L.append("")
L.append("TCO 單位 M USD,14 年(研發 3 + 部署 1 + 營運 10),含補網。「服務比例」是基準需求被滿足的時間平均比例。"
"「每 GB」= 年化成本 / 基準需求被滿足的年流量。")
L.append("")
L.append("## 表 2:最敏感的成本參數(以 %.0f km、%d 顆為例,基準 TCO %.0f M USD)" % (tor.iloc[0].h_km, tor.iloc[0].N, tor.iloc[0].tco_base))
L.append("")
t2 = tor.head(8).copy()
t2["幅度"] = t2.tco_high - t2.tco_low
t2 = t2[["desc", "param", "tco_low", "tco_high", "幅度"]]
t2.columns = ["參數", "代號", "取低值時 TCO", "取高值時 TCO", "幅度"]
L.append(md_table(t2, {"取低值時 TCO": fmt0, "取高值時 TCO": fmt0, "幅度": fmt0}))
L.append("")
L.append("## 表 3:星間鏈路 + 再生式的邊際價值(只看太平島可用度)")
L.append("")
t3 = isl[isl.f_den != 24][["h_km", "N", "f_den", "n_isl", "extra_tco_musd", "taiping_gain_points", "musd_per_point"]].copy()
t3 = t3[((t3.h_km == 550) & (t3.N == 144)) | ((t3.h_km == 800) & (t3.N == 144)) | ((t3.h_km == 1200) & (t3.N == 96))]
t3.columns = ["高度 km", "星數", "具 ISL 比例", "具 ISL 顆數", "多花 M USD", "太平島可用度增加(百分點)", "每增加 1 點(M USD)"]
L.append(md_table(t3, {"高度 km": fmt0, "星數": fmt0, "具 ISL 比例": lambda x: "1/%d" % int(x),
"具 ISL 顆數": fmt0, "多花 M USD": fmt0,
"太平島可用度增加(百分點)": lambda x: "%.2f" % x,
"每增加 1 點(M USD)": lambda x: "—" if str(x) == "nan" else "%.0f" % float(x)}))
L.append("")
L.append("「—」表示增加不到 0.05 個百分點。溢價用每顆 %.1f M USD(假設)計。" % 1.0)
L.append("")
L.append("## 表 4:韌性(基準需求,晴天)")
L.append("")
rows = []
for (h, N), g in res.groupby(["h_km", "N"]):
if not g.scenario.eq("S0").any():
continue
def v(sc, key, col="frac_mean"):
x = g[(g.scenario == sc) & g.detail.str.contains(key, regex=False) & ~g.detail.str.contains("最差")]
return float(x[col].iloc[0]) if len(x) else float("nan")
rows.append([h, N, v("S0", "基準"), v("S1", "失效 5%"), v("S1", "失效 10%"), v("S1", "失效 10%", "frac_p05"),
v("S3", "-10 dB"), v("S3", "-15 dB"), v("S3", "-20 dB")])
t4 = pd.DataFrame(rows, columns=["高度 km", "星數", "基準", "失效 5%", "失效 10%", "失效 10% 最差5%時刻",
"鏈路 -10 dB", "鏈路 -15 dB", "鏈路 -20 dB"])
L.append(md_table(t4, {c: (lambda x: "%.3f" % x) for c in t4.columns[2:]} | {"高度 km": fmt0, "星數": fmt0}))
L.append("")
L.append("數字是服務比例。本島三座閘道彼此只差 100~200 km,看得到的衛星幾乎相同,"
"所以可見性上閘道數量不增加可用度;閘道的價值在地理與電力的獨立性,本模型看不到。")
L.append("")
L.append("## 表 5:離軌與運作風險")
L.append("")
t5 = dec.copy()
t5.columns = ["高度 km", "自然衰減(低太陽活動)年", "自然衰減(中)年", "自然衰減(高)年", "離軌 delta-V m/s", "離軌推進劑 kg", "每次發射顆數"]
L.append(md_table(t5, {"高度 km": fmt0, "自然衰減(低太陽活動)年": lambda x: "—" if str(x) in ("inf", "nan") else "%.0f" % float(x),
"自然衰減(中)年": lambda x: "—" if str(x) in ("inf", "nan") else "%.0f" % float(x),
"自然衰減(高)年": lambda x: "—" if str(x) in ("inf", "nan") else "%.0f" % float(x),
"離軌 delta-V m/s": fmt0, "離軌推進劑 kg": lambda x: "%.1f" % x, "每次發射顆數": fmt0}))
L.append("")
L.append("「—」表示超過 500 年。550 km 的自然衰減對太陽活動很敏感(2~13 年),不能只靠衰減離軌;800 km 以上必須主動離軌。")
L.append("")
L.append("與既有 OneWeb(651 顆,1200 km、87.9°)的近距離事件(24 小時,篩選等級;模型誤差約 10~20 km,只適合比較相對風險):")
L.append("")
t6 = ops_ow[["h_km", "N", "lt10km", "lt25km", "lt50km"]].copy()
t6.columns = ["高度 km", "星數", "< 10 km", "< 25 km", "< 50 km"]
L.append(md_table(t6, {c: fmt0 for c in t6.columns}))
L.append("")
L.append("## 做決策前應該先問的問題")
L.append("")
L.append("1. **需求是多少?** 本摘要的 %.1f Gbps 是假設。容量、星數與成本都隨它變;先確定「斷纜時要保住哪些流量」。" % DEMAND_BASE)
L.append("2. **服務等級要求是平均還是最差?** 99% 的平均可用度與「任何時刻都不中斷」是兩個價錢。")
L.append("3. **軌道高度與現有殼層的關係。** 成本最低的高度可能與既有星座重疊,交會迴避的營運成本沒有算進 TCO。")
L.append("4. **饋線頻譜取得得到嗎?** 容量由它決定;頻譜與執照的取得時程與費用才是真正的不確定項。")
L.append("5. **成本參數換成實際報價後,敏感度排序是否改變?** 龍捲風圖的前兩名是可以先去問價的項目。")
L.append("")
L.append("## 本摘要沒有涵蓋的")
L.append("")
L.append("- 終端設備的補貼與通路、頻譜與法規的法律意見、保險的實際承保條件。")
L.append("- 1200 km 的輻射環境(范艾倫帶內帶邊緣)對衛星成本的影響。")
L.append("- 閘道天線數與回傳線路的實際成本(只用同時服務衛星峰值 x 1.5 估天線數)。")
L.append("- 備援價值本身(一天中斷的損失)—— 需要情境假設,本章刻意不估。")
L.append("")
L.append("---")
L.append("產生:`python tw_brief.py`。資料:`results/*.csv`。完整方法見 `TaiwanLEO_Primer.md`。")
io.open(os.path.join(HERE, "TaiwanLEO_Decision_Brief.md"), "w", encoding="utf-8", newline="\n").write("\n".join(L) + "\n")
print("寫出 TaiwanLEO_Decision_Brief.md(%d 行)與 results/cost.png" % len(L))
if __name__ == "__main__":
main()
# -*- coding: utf-8 -*-
r"""節 6:容量 —— 這個星座能把多少流量送到各個需求節點。

    python tw_capacity.py --verify    # 只跑驗證
    python tw_capacity.py             # 全掃描 -> results/capacity.csv

## 模型(第一階近似,所有參數都是假設,類別同 tw_link.py:A 假設、B 典型、C 常數)

需求節點:把服務區拆成 14 個節點(本島 4 區、5 座離島、海上 5 區),每個節點有一個需求量(Gbps),
低 / 基準 / 高 三種情境。需求量是**假設**(A),不是統計數字 —— 它的作用是讓供給能力有一個
可比較的尺度,結論該看「供給隨星數、高度如何變」,而不是絕對數字。

供給:
  - 每顆衛星 B 個可操控的使用者波束(A:16),每個波束 4 個 250 MHz 下行載波(A:共 1 GHz);
    波束速率取 tw_link 鏈路預算在該仰角下的下行速率(晴天,或含雨衰)。
  - 每顆衛星的饋線容量上限 F(A:饋線 2 GHz,速率由 tw_link 的饋線 SNR 與調變效率得出)。
  - 彎管架構:節點只能用「同時看得到節點與某座境內閘道」的衛星(與節 5 相同)。
  - 一個節點可同時用多顆衛星;每顆衛星的波束數與饋線容量在它所服務的節點之間分配,
    依優先序(生命線:本島 > 離島 > 海上)貪婪分配。
  - 上行:假設上下行比 1:5 且上行頻寬足夠,不構成限制(A)。

本節**不含星間鏈路**:ISL 只影響太平島的可用度(節 5),而太平島的需求很小,對容量沒有實質影響。

輸出:服務比例(需求被滿足的比例,時間平均與最差 5% 時刻)、各節點服務比例、
「容量上限」(把需求放大到不構成限制時,整個區域平均能送出多少 Gbps)。

## 驗證

  1. 守恆:任何時刻、任何衛星,使用的波束數 <= B,使用的饋線 <= F;服務量 <= 需求量
  2. 單調:需求情境 低 -> 基準 -> 高 時,服務的絕對量不減;服務比例不增
  3. 手算對照:單顆衛星、單一節點的簡化情境,與手算結果一致
  4. 上界:容量上限 <= (平均可同時服務的衛星數) x min(B x 波束速率, F)
"""
import csv
import math
import os
import sys
import time

import numpy as np

import tw_isl as I
import tw_link as L
import tw_sweep as W

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")

BEAMS_PER_SAT = 16                 # A
CARRIERS_PER_BEAM = 4              # A:4 x 250 MHz = 1 GHz
FEEDER_BW_MHZ = 2000.0             # A

# 需求節點:(名稱, 緯度, 經度, 低, 基準, 高 [Gbps]);順序即優先序。座標與需求量皆為假設(A)
NODES = [
    ("本島北", 25.00, 121.50, 2.0, 5.0, 10.0),
    ("本島中", 24.20, 120.70, 1.0, 3.0, 6.0),
    ("本島南", 22.80, 120.40, 1.0, 3.0, 6.0),
    ("本島東", 23.90, 121.50, 0.2, 0.5, 1.0),
    ("澎湖", 23.57, 119.58, 0.3, 0.8, 1.5),
    ("金門", 24.45, 118.38, 0.3, 0.8, 1.5),
    ("馬祖", 26.16, 119.95, 0.05, 0.15, 0.3),
    ("東沙", 20.70, 116.72, 0.01, 0.03, 0.06),
    ("太平島", 10.38, 114.36, 0.01, 0.03, 0.06),
    ("海上-北", 26.60, 122.60, 0.2, 0.6, 1.2),
    ("海上-東", 23.50, 123.80, 0.2, 0.6, 1.2),
    ("海上-南", 21.00, 120.60, 0.2, 0.6, 1.2),
    ("海上-海峽", 23.80, 118.80, 0.2, 0.6, 1.2),
    ("海上-東沙", 20.70, 118.50, 0.2, 0.6, 1.2),
]
SCEN = {"low": 3, "base": 4, "high": 5}


def beam_rate_table(h, rain, extra_db=0.0):
    """仰角 -> 每個使用者波束的下行速率(Gbps),線性內插表。

    extra_db:使用者下行額外損耗(干擾或壓制的抽象代表),由 SNR 扣除後重算速率。"""
    els = np.arange(25.0, 90.1, 5.0)
    if extra_db:
        r = np.array([L.rate_mbps(L.user_link(h, e, rain)["snr_dl_db"] - extra_db, L.p("dl_bw_mhz"))
                      for e in els]) * CARRIERS_PER_BEAM / 1000.0
    else:
        r = np.array([L.user_link(h, e, rain)["rate_dl_mbps"] for e in els]) * CARRIERS_PER_BEAM / 1000.0
    return els, r


def feeder_cap_gbps(h, rain=True):
    fl = L.feeder_link(h, rain)
    return L.rate_mbps(fl["snr_dn_db"], FEEDER_BW_MHZ) / 1000.0


def allocate(vis_j, el_j, gvis, demand, beams_left, feed_left, rate_fn):
    """對一個節點:依仰角由高到低向可用衛星要資源。回傳服務量(Gbps)。就地更新 beams_left / feed_left。"""
    cand = np.flatnonzero(vis_j & gvis)
    if cand.size == 0:
        return 0.0
    cand = cand[np.argsort(-el_j[cand])]
    left = demand
    served = 0.0
    for s in cand:
        if left <= 1e-12:
            break
        rb = rate_fn(el_j[s])
        k = int(min(beams_left[s], math.ceil(left / rb - 1e-12)))
        if k <= 0 or feed_left[s] <= 1e-12:
            continue
        use = min(left, k * rb, feed_left[s])
        k = min(k, int(math.ceil(use / rb - 1e-12)))
        beams_left[s] -= k
        feed_left[s] -= use
        served += use
        left -= use
    return served


def run(design, demand_vec, rain, stride=1, check=False, sat_ok=None, gw_idx=None, extra_db=0.0):
    """時間平均的各節點服務量。demand_vec:(14,) Gbps。回傳 dict。

    sat_ok:(N,) 布林,False 的衛星視為失效(不可見、不可中繼)。
    gw_idx:可用閘道的索引(預設全部);空清單 = 沒有任何閘道。
    extra_db:使用者下行額外損耗(抽象的干擾 / 壓制)。"""
    h = design.h
    els, rt = beam_rate_table(h, rain, extra_db)
    gw_all = design.GW
    if gw_idx is not None:
        design.GW = gw_all[list(gw_idx)] if len(gw_idx) else np.zeros((0, 3))
    rate_fn = lambda e: float(np.interp(e, els, rt))              # noqa: E731
    F = feeder_cap_gbps(h, rain)
    T = len(design.times)
    nn = len(demand_vec)
    served_t = np.zeros((len(range(0, T, stride)), nn))
    nsat_t = []
    for k, t in enumerate(range(0, T, stride)):
        vis, dist, gvis, _gd = design.step(t)
        if sat_ok is not None:
            vis = vis & sat_ok[None, :]
            gvis = gvis & sat_ok
        dots = (design.a ** 2 + W.RE ** 2 - dist ** 2) / (2 * design.a * W.RE)
        sin_el = np.clip((design.a * dots - W.RE) / dist, -1, 1)
        el = np.degrees(np.arcsin(sin_el))
        beams_left = np.full(design.N, BEAMS_PER_SAT, dtype=int)
        feed_left = np.full(design.N, F)
        for j in range(nn):
            served_t[k, j] = allocate(vis[j], el[j], gvis, demand_vec[j], beams_left, feed_left, rate_fn)
        if check:
            assert (beams_left >= 0).all() and (feed_left >= -1e-9).all(), "資源超用"
            used_b = BEAMS_PER_SAT - beams_left
            assert (used_b <= BEAMS_PER_SAT).all()
            assert (served_t[k] <= demand_vec + 1e-9).all(), "服務量超過需求"
            assert served_t[k].sum() <= F * design.N + 1e-9
        nsat_t.append(int(((vis & gvis[None, :]).any(axis=0)).sum()))
    design.GW = gw_all
    tot_dem = demand_vec.sum()
    frac_t = served_t.sum(axis=1) / tot_dem
    return {"frac_mean": float(frac_t.mean()), "frac_p05": float(np.percentile(frac_t, 5)),
            "gbps_mean": float(served_t.sum(axis=1).mean()),
            "node_frac": (served_t.mean(axis=0) / demand_vec).tolist(),
            "nsat_mean": float(np.mean(nsat_t)), "nsat_peak": int(np.max(nsat_t)), "F": F, "R_beam_25": rate_fn(25.0), "R_beam_90": rate_fn(90.0)}


def make_design(h, N, wb, hours=24.0, dt=120.0):
    r = wb[(wb.h_km == h) & (wb.N == N)].iloc[0]
    lat = np.array([n[1] for n in NODES])
    lon = np.array([n[2] for n in NODES])
    return I.Design(int(r.N), int(r.P), int(r.F), float(r.inc_deg), h, (lat, lon, np.ones(len(lat))), hours=hours, dt=dt)


def load_best():
    import pandas as pd
    wb = pd.read_csv(os.path.join(RES, "walker_best.csv"))
    return wb[(wb.limit == "practical") & (wb.inc_label == "25") & (wb.el_deg == 25.0)]


# ---------------------------------------------------------------- 驗證
def verify():
    ok = True
    wb = load_best()
    d = make_design(800.0, 72, wb, hours=6.0, dt=120.0)
    dem = {k: np.array([n[i] for n in NODES]) for k, i in SCEN.items()}
    # 1. 守恆(run 內以 assert 檢查)
    try:
        res = {k: run(d, dem[k], rain=False, check=True) for k in SCEN}
        print("  守恆:波束數、饋線、需求上限 在每個時刻都未超用 -> 通過")
    except AssertionError as e:
        print("  守恆檢查失敗:%s" % e)
        return False
    # 2. 單調
    g = [res[k]["gbps_mean"] for k in ("low", "base", "high")]
    f = [res[k]["frac_mean"] for k in ("low", "base", "high")]
    mono = g[0] <= g[1] + 1e-9 <= g[2] + 2e-9 and f[0] >= f[1] - 1e-9 >= f[2] - 2e-9
    print("  單調:服務量 低/基準/高 = %.3f / %.3f / %.3f Gbps;服務比例 %.3f / %.3f / %.3f -> %s"
          % (g[0], g[1], g[2], f[0], f[1], f[2], "通過" if mono else "不單調"))
    ok &= mono
    # 3. 手算:單顆衛星(N=1),單一節點(把節點 0 放在衛星正下方附近,其餘需求 0)
    h = 800.0
    a, inc, raan0, u0 = W.walker_elements(1, 1, 0, 25.0, h)
    times = np.array([0.0])
    S = W.sat_ecef(a, inc, raan0, u0, times)[0, 0]
    lat0 = math.degrees(math.asin(S[2] / np.linalg.norm(S)))
    lon0 = math.degrees(math.atan2(S[1], S[0]))
    dsn = I.Design.__new__(I.Design)
    dsn.N, dsn.h = 1, h
    dsn.a = a
    dsn.times = times
    dsn.S = S[None, None, :]
    dsn.Su = dsn.S / a
    dsn.lat, dsn.lon, dsn.w = np.array([lat0]), np.array([lon0]), np.ones(1)
    dsn.G = W.grid_unit(dsn.lat, dsn.lon)
    dsn.cos_user = math.cos(W.lam_limit(h, I.USER_EL))
    dsn.cos_gw = math.cos(W.lam_limit(h, I.GW_EL))
    # 閘道放在節點正下方(同一點),保證看得到
    dsn.GW = W.grid_unit(np.array([lat0]), np.array([lon0]))
    dsn.region = np.zeros(1, dtype=int)
    big = np.array([1000.0])
    res1 = run(dsn, big, rain=False)
    expect_beams = min(BEAMS_PER_SAT * L.user_link(h, 90.0, False)["rate_dl_mbps"] * CARRIERS_PER_BEAM / 1000.0,
                       feeder_cap_gbps(h, False))
    got = res1["gbps_mean"]
    print("  手算(單星、正下方、需求不限):波束上限 vs 饋線上限 取小 = %.3f Gbps;模型 %.3f Gbps" % (expect_beams, got))
    ok &= abs(got - expect_beams) < 1e-6 * max(1.0, expect_beams)
    # 4. 上界
    big_all = np.array([n[5] * 1000 for n in NODES])
    resb = run(d, big_all, rain=False)
    bound = resb["nsat_mean"] * min(BEAMS_PER_SAT * resb["R_beam_90"], resb["F"])
    print("  上界:容量上限 %.1f Gbps <= 平均可服務衛星數 %.1f x min(波束上限, 饋線上限) = %.1f Gbps -> %s"
          % (resb["gbps_mean"], resb["nsat_mean"], bound, "通過" if resb["gbps_mean"] <= bound + 1e-6 else "超過上界"))
    ok &= resb["gbps_mean"] <= bound + 1e-6
    print("驗證:%s" % ("PASS" if ok else "FAIL"))
    return ok


def main(argv):
    if "--verify" in argv:
        return 0 if verify() else 1
    if not verify():
        return 1
    wb = load_best()
    dem = {k: np.array([n[i] for n in NODES]) for k, i in SCEN.items()}
    ceil_dem = np.array([n[5] * 1000 for n in NODES])
    rows = []
    t0 = time.time()
    for h in (550.0, 800.0, 1200.0):
        for N in (48, 72, 96, 144, 192, 240):
            d = make_design(h, N, wb)
            for rain in (False, True):
                out = {}
                for k in SCEN:
                    out[k] = run(d, dem[k], rain, stride=2)
                cap = run(d, ceil_dem, rain, stride=2)
                rows.append([h, N, "雨" if rain else "晴", "%.1f" % cap["nsat_mean"], cap["nsat_peak"], "%.2f" % cap["gbps_mean"],
                             "%.3f" % out["low"]["frac_mean"], "%.3f" % out["base"]["frac_mean"],
                             "%.3f" % out["base"]["frac_p05"], "%.3f" % out["high"]["frac_mean"],
                             "%.2f" % out["base"]["R_beam_25"], "%.2f" % out["base"]["F"]]
                            + ["%.3f" % x for x in out["base"]["node_frac"]])
                print("h=%4.0f N=%3d %s  容量上限 %7.1f Gbps  服務比例 低 %.3f 基準 %.3f(p05 %.3f)高 %.3f  (%.0f s)"
                      % (h, N, "雨" if rain else "晴", cap["gbps_mean"], out["low"]["frac_mean"], out["base"]["frac_mean"],
                         out["base"]["frac_p05"], out["high"]["frac_mean"], time.time() - t0), flush=True)
    with open(os.path.join(RES, "capacity.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["h_km", "N", "weather", "nsat_serving", "nsat_serving_peak", "capacity_ceiling_gbps", "frac_low", "frac_base",
                    "frac_base_p05", "frac_high", "beam_rate_25_gbps", "feeder_cap_gbps"]
                   + ["frac_" + n[0] for n in NODES])
        w.writerows(rows)
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""節 6 敏感度:饋線頻寬與每星波束數,哪一個才是容量的瓶頸。

基準模型的容量上限剛好等於「可服務衛星數 x 饋線上限」—— 饋線是瓶頸。
這裡掃饋線頻寬 {1, 2, 4, 8} GHz 與每星波束數 {8, 16, 32},看容量上限與基準需求的服務比例。
"""
import csv
import os

import numpy as np

import tw_capacity as C

HERE = os.path.dirname(os.path.abspath(__file__))
wb = C.load_best()
dem = np.array([n[4] for n in C.NODES])
ceil_dem = np.array([n[5] * 1000 for n in C.NODES])
rows = []
for h, N in ((550.0, 144), (800.0, 96), (1200.0, 72)):
    d = C.make_design(h, N, wb)
    for fbw in (1000.0, 2000.0, 4000.0, 8000.0):
        for nb in (8, 16, 32):
            C.FEEDER_BW_MHZ, C.BEAMS_PER_SAT = fbw, nb
            cap = C.run(d, ceil_dem, False, stride=2)
            base = C.run(d, dem, False, stride=2)
            bind = "饋線" if cap["F"] <= nb * cap["R_beam_90"] else "波束"
            rows.append([h, N, fbw, nb, "%.1f" % cap["gbps_mean"], "%.3f" % base["frac_mean"], bind])
            print("h=%4.0f N=%3d 饋線 %4.0f MHz 波束 %2d  容量上限 %6.1f Gbps  服務比例 %.3f  瓶頸:%s"
                  % (h, N, fbw, nb, cap["gbps_mean"], base["frac_mean"], bind), flush=True)
with open(os.path.join(HERE, "results", "capacity_sensitivity.csv"), "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["h_km", "N", "feeder_bw_mhz", "beams", "capacity_ceiling_gbps", "frac_base", "bottleneck"])
    w.writerows(rows)
# -*- coding: utf-8 -*-
r"""節 10:成本 —— 總擁有成本(TCO)、單位成本與敏感度。給財務長的那一節。

    python tw_cost.py --verify
    python tw_cost.py                    # -> results/cost_*.csv、cost.png

## 讀這一節前請先知道

**所有成本參數都是假設(類別 A),沒有任何一項來自特定計畫或廠商報價。**
每個參數給低 / 基準 / 高三個值,量級取自公開文獻對小型 LEO 通訊衛星與小型運載火箭的常見範圍,
**沒有逐項查證**,使用前請以實際報價取代。本節的價值在結構:
哪些項目驅動成本、成本如何隨星數與高度變、哪個參數最敏感 —— 不在任何一個絕對數字。

結果只用區間表示(低 / 基準 / 高,以及蒙地卡羅的 P10 / P50 / P90),不給單點估計。
金額單位:百萬美元(M USD),未換算匯率。

## 模型

時程:研發 3 年 -> 部署 1 年 -> 營運 10 年(共 14 年)。
CAPEX:
  衛星 = 研發(NRE)+ 量產,量產用 Wright 學習曲線:第 n 顆成本 = c1 * n^k,k = log2(學習率),學習率 0.90(A);
  具星間鏈路 + 再生式處理的衛星另加每顆溢價;
  發射 = 次數 x 每次單價,每次載 k 顆(tw_replenish);
  地面 = 閘道站(3 座 x 站址 + 天線數 x 單價,天線數 = 同時服務衛星數的峰值 x 1.5 備援)
        + TT&C 站 2 座 + 營運中心;
  頻譜與執照(一次性)、保險(發射與衛星價值的一定比例,首次部署與每次補網都付)。
OPEX(營運年):維運人力、地面維護(地面 CAPEX 的 4%/年)、軟體與資安、頻譜年費、
  補網(依 tw_replenish 的造星率與發射率;含保險)。
折現:基準 8%/年(低 5%、高 12%);同時報告未折現的總和與現值(NPV)。

單位成本:
  每 Gbps-年 = 年化總成本 / 容量上限(Gbps)
  每 GB = 年化總成本 / (基準需求被滿足的平均流量換算成每年 GB)

## 驗證

  1. 恆等:TCO = 各項成本之和 = 逐年現金流之和
  2. Wright 學習曲線:向量化的加總 vs 逐顆迴圈 vs 積分近似(N >= 48 時 < 2%)
  3. 獨立重算:用「試算表式」逐列計算的另一套實作,對基準情境逐項一致(< 1e-9)
  4. 單調:任何單價上升,TCO 不降;折現後的現值 < 未折現;星數越多 TCO 越高(其他不變)
  5. 單位:1 Gbps 持續一年 = 3.944e6 GB(換算檢查)
"""
import csv
import math
import os
import sys

import numpy as np

import tw_replenish as RP

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")

# ---- 參數表:name -> (低, 基準, 高, 單位, 說明);類別一律為 A -----------------
PARAMS = {
    "c1_sat":         (4.0, 8.0, 15.0, "M USD", "第一顆衛星的量產成本"),
    "learning":       (0.85, 0.90, 0.95, "",      "學習率(越小學得越快)"),
    "nre_sat":        (60.0, 120.0, 250.0, "M USD", "衛星研發與鑑定(NRE)"),
    "isl_premium":    (0.5, 1.0, 2.0, "M USD",   "每顆具星間鏈路 + 再生式處理的衛星溢價"),
    "launch_cost":    (8.0, 15.0, 30.0, "M USD", "每次發射單價"),
    "gw_site":        (3.0, 5.0, 10.0, "M USD",  "閘道站址(每座,含土建與機房)"),
    "gw_antenna":     (1.5, 3.0, 5.0, "M USD",   "閘道追蹤天線(每具)"),
    "ttc_station":    (1.0, 2.0, 4.0, "M USD",   "TT&C 站(每座)"),
    "noc":            (10.0, 20.0, 40.0, "M USD", "營運與任務控制中心"),
    "spectrum_once":  (2.0, 5.0, 15.0, "M USD",  "頻譜、協調與執照(一次性)"),
    "spectrum_year":  (1.0, 2.0, 5.0, "M USD",   "頻譜年費"),
    "insurance":      (0.05, 0.08, 0.12, "",     "保險費率(佔該批衛星與發射價值)"),
    "staff_fte":      (25.0, 40.0, 70.0, "FTE",  "維運人力"),
    "staff_cost":     (0.12, 0.15, 0.20, "M USD/FTE-年", "每人年成本"),
    "ground_maint":   (0.03, 0.04, 0.06, "",     "地面維護(佔地面 CAPEX 每年)"),
    "software_year":  (2.0, 4.0, 8.0, "M USD",   "軟體與資安(每年)"),
    "discount":       (0.05, 0.08, 0.12, "",     "折現率"),
}
DEV_YEARS, DEPLOY_YEARS, OPS_YEARS = 3, 1, 10
ANT_REDUNDANCY = 1.5
GB_PER_GBPS_YEAR = 1e9 / 8 * 365.25 * 86400 / 1e9          # 1 Gbps 一年的 GB 數


def pick(which):
    idx = {"low": 0, "base": 1, "high": 2}[which]
    return {k: v[idx] for k, v in PARAMS.items()}


def sat_cost_total(n_units, c1, learning, start=1):
    """第 start 到 start+n-1 顆的 Wright 成本加總(向量化)。"""
    k = math.log2(learning)
    return float(c1 * np.sum(np.arange(start, start + n_units, dtype=float) ** k))


def tco(design, p):
    """design:dict(h, N, n_isl, antennas_peak, ...)。回傳逐項成本與逐年現金流。"""
    h, N = design["h"], design["N"]
    n_isl = design.get("n_isl", 0)
    k_per_launch = RP.sats_per_launch(h)
    lam = RP.failure_rate()
    tau = (1 - math.exp(-lam * RP.P("life_years"))) / lam
    build_per_year = N * (1 + RP.P("doa")) / tau                    # 營運期每年補造的衛星數
    antennas = int(math.ceil(design["antennas_peak"] * ANT_REDUNDANCY))

    items = {}
    # 初始部署
    init_sat = sat_cost_total(N, p["c1_sat"], p["learning"])
    init_isl = n_isl * p["isl_premium"]
    init_launches = math.ceil(N / k_per_launch)
    init_launch = init_launches * p["launch_cost"]
    ground = 3 * p["gw_site"] + antennas * p["gw_antenna"] + 2 * p["ttc_station"] + p["noc"]
    items["衛星研發(NRE)"] = p["nre_sat"]
    items["衛星量產(初始 N 顆)"] = init_sat
    items["星間鏈路與再生式溢價(初始)"] = init_isl
    items["發射(初始部署)"] = init_launch
    items["地面段"] = ground
    items["頻譜與執照(一次性)"] = p["spectrum_once"]
    items["保險(初始部署)"] = p["insurance"] * (init_sat + init_isl + init_launch)
    # 營運期:逐年
    ops_rows = []
    for y in range(OPS_YEARS):
        n_new = build_per_year
        k = math.log2(p["learning"])
        mid = sats_built + n_new / 2.0
        unit = p["c1_sat"] * mid ** k
        rep_sat = n_new * unit
        rep_isl = n_new * (n_isl / N) * p["isl_premium"]
        rep_launch = (n_new / k_per_launch) * p["launch_cost"]
        rep_ins = p["insurance"] * (rep_sat + rep_isl + rep_launch)
        staff = p["staff_fte"] * p["staff_cost"]
        maint = p["ground_maint"] * ground
        soft = p["software_year"]
        spec = p["spectrum_year"]
        ops_rows.append({"補網衛星": rep_sat, "補網溢價": rep_isl, "補網發射": rep_launch, "補網保險": rep_ins,
                         "人力": staff, "地面維護": maint, "軟體與資安": soft, "頻譜年費": spec})
        sats_built += n_new
    for key in ops_rows[0]:
        items["營運 10 年:" + key] = sum(r[key] for r in ops_rows)
    total = float(sum(items.values()))
    # 逐年現金流:研發期把 NRE、地面與頻譜按年平攤;部署年付衛星與發射與保險;之後逐年營運
    flows = []
    pre = items["衛星研發(NRE)"] + items["地面段"] + items["頻譜與執照(一次性)"]
    for _ in range(DEV_YEARS):
        flows.append(pre / DEV_YEARS)
    flows.append(items["衛星量產(初始 N 顆)"] + items["星間鏈路與再生式溢價(初始)"]
                 + items["發射(初始部署)"] + items["保險(初始部署)"])
    for r in ops_rows:
        flows.append(sum(r.values()))
    flows = np.array(flows)
    r = p["discount"]
    npv = float(np.sum(flows / (1 + r) ** np.arange(1, len(flows) + 1)))
    ops_total = float(flows[DEV_YEARS + DEPLOY_YEARS:].sum())
    capex_part = total - ops_total
    annual_ops = ops_total / OPS_YEARS
    annualized = total / (DEV_YEARS + DEPLOY_YEARS + OPS_YEARS)
    return {"items": items, "total": total, "flows": flows, "npv": npv, "annualized": annualized,
            "annual_ops": annual_ops, "capex_part": capex_part, "launches_init": init_launches,
            "build_per_year": build_per_year, "antennas": antennas}


# ---------------------------------------------------------------- 獨立實作(試算表式)
def tco_spreadsheet(design, p):
    """逐列、純 Python 迴圈的另一套實作,用來和 tco() 對帳。只回傳總和與現值。"""
    h, N = design["h"], design["N"]
    n_isl = design.get("n_isl", 0)
    k = math.log(p["learning"]) / math.log(2.0)
    per_launch = max(1, int((RP.P("launch_cap_kg") * RP.CAP_DERATE[h] * 0.9) // RP.P("sat_mass_kg")))
    lam = -math.log(RP.P("survive_life")) / RP.P("life_years")
    L = RP.P("life_years")
    tau = (1.0 - math.exp(-lam * L)) / lam
    rate = N * (1.0 + RP.P("doa")) / tau
    ant = math.ceil(design["antennas_peak"] * 1.5)
    rows = []                                                      # (年, 金額)
    # 研發期
    ground = 3 * p["gw_site"] + ant * p["gw_antenna"] + 2 * p["ttc_station"] + p["noc"]
    pre = p["nre_sat"] + ground + p["spectrum_once"]
    for y in range(1, 4):
        rows.append((y, pre / 3.0))
    # 部署年
    s = 0.0
    for n in range(1, N + 1):
        s += p["c1_sat"] * (n ** k)
    isl = n_isl * p["isl_premium"]
    launch = math.ceil(N / per_launch) * p["launch_cost"]
    rows.append((4, s + isl + launch + p["insurance"] * (s + isl + launch)))
    # 營運期
    built = float(N)
    for y in range(5, 15):
        new = rate
        unit = p["c1_sat"] * (built + new / 2.0) ** k
        a = new * unit
        b = new * (n_isl / N) * p["isl_premium"]
        c = new / per_launch * p["launch_cost"]
        ins = p["insurance"] * (a + b + c)
        opex = p["staff_fte"] * p["staff_cost"] + p["ground_maint"] * ground + p["software_year"] + p["spectrum_year"]
        rows.append((y, a + b + c + ins + opex))
        built += new
    total = sum(v for _y, v in rows)
    npv = sum(v / (1.0 + p["discount"]) ** y for y, v in rows)
    return total, npv


# ---------------------------------------------------------------- 設計輸入
def load_designs():
    """每個 (h, N) 一列:服務比例、容量上限、同時服務衛星峰值,取自節 6 的 capacity.csv(晴天)。"""
    import pandas as pd
    c = pd.read_csv(os.path.join(RES, "capacity.csv"))
    c = c[c.weather == "晴"]
    out = []
    for _i, r in c.iterrows():
        out.append({"h": float(r.h_km), "N": int(r.N), "frac_base": float(r.frac_base),
                    "ceiling_gbps": float(r.capacity_ceiling_gbps), "antennas_peak": int(r.nsat_serving_peak),
                    "frac_p05": float(r.frac_base_p05)})
    return out


# ---------------------------------------------------------------- 驗證
def verify():
    ok = True
    d = {"h": 800.0, "N": 144, "n_isl": 0, "antennas_peak": 4}
    p = pick("base")
    res = tco(d, p)
    # 1. 恆等:項目和 = 現金流和
    s_items = sum(res["items"].values())
    s_flows = float(res["flows"].sum())
    print("  恆等:各項成本之和 %.6f M USD;逐年現金流之和 %.6f M USD(差 %.2e)" % (s_items, s_flows, abs(s_items - s_flows)))
    ok &= abs(s_items - s_flows) < 1e-6 and abs(res["total"] - s_items) < 1e-9
    # 2. Wright:向量化 vs 迴圈 vs 積分近似
    for N in (48, 144, 240):
        k = math.log2(p["learning"])
        loop = sum(p["c1_sat"] * n ** k for n in range(1, N + 1))
        vec = sat_cost_total(N, p["c1_sat"], p["learning"])
        integ = p["c1_sat"] * (N ** (k + 1) - 1) / (k + 1) + p["c1_sat"] * (1 + N ** k) / 2 - p["c1_sat"] * 0.5 * 0   # 梯形修正
        e1 = abs(loop - vec) / loop
        e2 = abs(loop - integ) / loop
        print("  Wright N=%3d:迴圈 %.4f、向量化 %.4f(差 %.1e);積分近似 %.4f(差 %.2f%%)" % (N, loop, vec, e1, integ, 100 * e2))
        ok &= e1 < 1e-9 and e2 < 0.02
    # 3. 獨立重算
    for n_isl in (0, 24):
        dd = dict(d, n_isl=n_isl)
        a = tco(dd, p)
        tot, npv = tco_spreadsheet(dd, p)
        print("  獨立重算(n_isl=%d):TCO %.9f vs %.9f;NPV %.9f vs %.9f" % (n_isl, a["total"], tot, a["npv"], npv))
        ok &= abs(a["total"] - tot) < 1e-9 * max(1, tot) and abs(a["npv"] - npv) < 1e-9 * max(1, npv)
    # 4. 單調
    base = tco(d, p)["total"]
    mono = True
    for k in ("c1_sat", "nre_sat", "launch_cost", "gw_site", "gw_antenna", "noc", "staff_fte", "software_year", "isl_premium"):
        q = dict(p)
        q[k] = p[k] * 1.5
        dd = dict(d, n_isl=24) if k == "isl_premium" else d
        b0 = tco(dd, p)["total"]
        mono &= tco(dd, q)["total"] >= b0 - 1e-12
    print("  單調:各單價 x1.5 後 TCO 皆不下降:%s" % mono)
    ok &= mono
    ok &= tco(d, p)["npv"] < tco(d, p)["total"]
    n_mono = all(tco(dict(d, N=n), p)["total"] <= tco(dict(d, N=n2), p)["total"] for n, n2 in ((48, 96), (96, 144), (144, 240)))
    print("  現值 %.1f < 未折現 %.1f:%s;星數越多 TCO 越高:%s" % (tco(d, p)["npv"], tco(d, p)["total"], tco(d, p)["npv"] < tco(d, p)["total"], n_mono))
    ok &= n_mono
    # 5. 單位
    print("  單位:1 Gbps 持續一年 = %.4e GB(期望 3.9446e+06)" % GB_PER_GBPS_YEAR)
    ok &= abs(GB_PER_GBPS_YEAR - 3.944700e6) / 3.9447e6 < 1e-4
    print("驗證:%s" % ("PASS" if ok else "FAIL"))
    return ok


# ---------------------------------------------------------------- 分析
def monte_carlo(design, n=4000, seed=7):
    """每個參數在 [低, 高] 上取三角分布(眾數 = 基準),回傳 TCO 與 NPV 的樣本。"""
    rng = np.random.default_rng(seed)
    tot, npv = [], []
    for _ in range(n):
        p = {k: float(rng.triangular(v[0], v[1], v[2])) for k, v in PARAMS.items()}
        r = tco(design, p)
        tot.append(r["total"])
        npv.append(r["npv"])
    return np.array(tot), np.array(npv)


def tornado(design):
    """一次動一個參數(低 / 高),其他取基準。回傳 [(參數, 低時 TCO, 高時 TCO)],依影響幅度排序。"""
    base = tco(design, pick("base"))["total"]
    out = []
    for k in PARAMS:
        lo, hi = dict(pick("base")), dict(pick("base"))
        lo[k], hi[k] = PARAMS[k][0], PARAMS[k][2]
        out.append((k, tco(design, lo)["total"], tco(design, hi)["total"]))
    out.sort(key=lambda x: -abs(x[2] - x[1]))
    return base, out


def isl_value(designs):
    """星間鏈路(+再生式)的錢花得值不值得:每多 1 個百分點的太平島可用度要多花多少 M USD。

    資料取自節 5 的 isl_trade.csv(具 ISL 的衛星數與各地區可用度)。溢價由 isl_premium 計(初始 + 補網)。"""
    import pandas as pd
    t = pd.read_csv(os.path.join(RES, "isl_trade.csv"))
    col = [c for c in t.columns if c.startswith("avail_") and "太平島" in c][0]
    rows = []
    print()
    print("星間鏈路 + 再生式的邊際價值(只看太平島可用度;基準 TCO 之上的增加量):")
    for (h, N), g in t.groupby(["h_km", "N"]):
        base_row = g[g.f_den == 0].iloc[0]
        d = {"h": float(h), "N": int(N), "n_isl": 0, "antennas_peak": 4}
        for dd in designs:
            if dd["h"] == h and dd["N"] == N:
                d["antennas_peak"] = dd["antennas_peak"]
        base = tco(d, pick("base"))["total"]
        for _i, r in g[g.f_den != 0].iterrows():
            dd = dict(d, n_isl=int(r.n_isl))
            extra = tco(dd, pick("base"))["total"] - base
            gain = (float(r[col]) - float(base_row[col])) * 100
            rows.append([h, N, int(r.f_den), int(r.n_isl), "%.1f" % extra, "%.2f" % gain,
                         "%.1f" % (extra / gain) if gain > 0.05 else "nan"])
    with open(os.path.join(RES, "cost_isl.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["h_km", "N", "f_den", "n_isl", "extra_tco_musd", "taiping_gain_points", "musd_per_point"])
        w.writerows(rows)
    for h, N in ((550.0, 144), (800.0, 144), (1200.0, 96)):
        for r in rows:
            if r[0] == h and r[1] == N:
                print("  h=%4.0f N=%3d  ISL 比例 1/%d(%3d 顆):多花 %6s M USD,太平島可用度 +%s 個百分點,每 +1 點 %s M USD"
                      % (h, N, r[2], r[3], r[4], r[5], r[6]))
    return rows


def main(argv):
    if "--verify" in argv:
        return 0 if verify() else 1
    if not verify():
        return 1
    designs = load_designs()
    rows = []
    for d in designs:
        lo, ba, hi = (tco(d, pick(w)) for w in ("low", "base", "high"))
        tot, npv = monte_carlo(d, n=1500)
        ann = ba["annualized"]
        cost_gbps_yr = ann / d["ceiling_gbps"]
        demand_gbps = d["frac_base"] * 17.1
        cost_per_gb = ann * 1e6 / (max(demand_gbps, 1e-9) * GB_PER_GBPS_YEAR)
        rows.append([d["h"], d["N"], "%.3f" % d["frac_base"], "%.3f" % d["frac_p05"], "%.1f" % d["ceiling_gbps"],
                     d["antennas_peak"], ba["antennas"], "%.0f" % lo["total"], "%.0f" % ba["total"], "%.0f" % hi["total"],
                     "%.0f" % np.percentile(tot, 10), "%.0f" % np.percentile(tot, 50), "%.0f" % np.percentile(tot, 90),
                     "%.0f" % ba["npv"], "%.1f" % ba["annualized"], "%.1f" % ba["annual_ops"], "%.2f" % cost_gbps_yr,
                     "%.2f" % cost_per_gb, "%.1f" % ba["build_per_year"], ba["launches_init"]])
        print("h=%4.0f N=%3d  服務比例 %.3f  容量上限 %6.1f Gbps  TCO 低/基準/高 %5.0f / %5.0f / %5.0f M USD  (MC P10-P90 %5.0f–%5.0f)"
              "  年化 %.1f M USD  每 Gbps-年 %.2f M USD  每 GB %.2f USD"
              % (d["h"], d["N"], d["frac_base"], d["ceiling_gbps"], lo["total"], ba["total"], hi["total"],
                 np.percentile(tot, 10), np.percentile(tot, 90), ann, cost_gbps_yr, cost_per_gb), flush=True)
    with open(os.path.join(RES, "cost_designs.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["h_km", "N", "frac_base", "frac_base_p05", "ceiling_gbps", "antennas_peak", "antennas_built",
                    "tco_low", "tco_base", "tco_high", "tco_mc_p10", "tco_mc_p50", "tco_mc_p90", "npv_base",
                    "annualized_musd", "annual_ops_musd", "musd_per_gbps_year", "usd_per_gb", "sats_built_per_year",
                    "initial_launches"])
        w.writerows(rows)
    isl_value(designs)
    # 敏感度:挑「滿足基準需求 >= 99%」中 TCO 最低的設計
    feas = [d for d in designs if d["frac_base"] >= 0.99]
    if feas:
        best = min(feas, key=lambda d: tco(d, pick("base"))["total"])
        base, tor = tornado(best)
        print("\n龍捲風圖(滿足基準需求 >= 99%% 且 TCO 最低:h=%.0f km、N=%d,基準 TCO %.0f M USD):" % (best["h"], best["N"], base))
        for k, lo_v, hi_v in tor[:8]:
            print("  %-14s 低 %6.0f   高 %6.0f   幅度 %6.0f M USD   (%s)" % (k, lo_v, hi_v, abs(hi_v - lo_v), PARAMS[k][4]))
        with open(os.path.join(RES, "cost_tornado.csv"), "w", newline="", encoding="utf-8") as f:
            w = csv.writer(f)
            w.writerow(["h_km", "N", "param", "desc", "tco_low", "tco_base", "tco_high"])
            for k, lo_v, hi_v in tor:
                w.writerow([best["h"], best["N"], k, PARAMS[k][4], "%.1f" % lo_v, "%.1f" % base, "%.1f" % hi_v])
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""衛星缺額 -> 服務比例 的曲線(供節 8 的補網模擬使用)。

三個參考設計,各取缺額比例 0、2、5、10、15、20、30%,以巢狀隨機失效、5 個種子取平均,
基準需求、晴天、彎管。輸出 results/degradation_curve.csv。
"""
import csv
import os

import numpy as np

import tw_capacity as C
import tw_resilience as R

HERE = os.path.dirname(os.path.abspath(__file__))
LEVELS = [0.0, 0.02, 0.05, 0.10, 0.15, 0.20, 0.30]
rows = []
dem = np.array([n[4] for n in C.NODES])
wb = C.load_best()
for h, N in R.REF:
    d = C.make_design(h, N, wb)
    for lv in LEVELS:
        k = int(round(lv * N))
        vals = []
        for seed in range(5):
            if k == 0:
                m = np.ones(N, dtype=bool)
            else:
                m = R.nested_failures(N, seed, [("x", k)])["x"]
            vals.append(C.run(d, dem, False, stride=2, sat_ok=m)["frac_mean"])
        rows.append([h, N, lv, k, "%.4f" % np.mean(vals), "%.4f" % np.min(vals)])
        print("h=%4.0f N=%3d 缺額 %4.0f%%(%3d 顆)  服務比例 平均 %.4f  最差 %.4f" % (h, N, lv * 100, k, np.mean(vals), np.min(vals)), flush=True)
with open(os.path.join(HERE, "results", "degradation_curve.csv"), "w", newline="", encoding="utf-8") as f:
    w = csv.writer(f)
    w.writerow(["h_km", "N", "missing_frac", "missing_sats", "frac_mean", "frac_min"])
    w.writerows(rows)
# -*- coding: utf-8 -*-
r"""節 5:彎管 vs 再生式 + 星間鏈路(ISL),具 ISL 衛星占比 f = 1/24、1/12、1/6。

    python tw_isl.py --verify     # 只跑驗證
    python tw_isl.py              # 全掃描 -> results/isl_trade.csv

## 架構定義(對應企劃的假設)

- 彎管:衛星只是中繼。使用者要有服務,必須存在一顆衛星**同時**看得到使用者(仰角 >= 25°)
  與某座境內閘道(仰角 >= 10°)。
- 再生式 + ISL(比例 f):只有 f 比例的衛星具備星間鏈路與星上交換。
  其餘衛星仍是彎管。使用者連到任一顆可見衛星 S:
    * S 自己看得到閘道 -> 可服務(與彎管相同);
    * 否則 S 必須具備 ISL,且經由 ISL 網路(只有具 ISL 的衛星彼此相連)
      到達某顆看得到閘道的具 ISL 衛星 -> 可服務。
- 具 ISL 的衛星以「黃金比例低差異序列」選取,且 f 越小的集合是 f 較大者的子集(巢狀),
  所以可用度對 f 必然單調;並用 3 個不同起點驗證結果不靠運氣。

## 假設(類別同 tw_link.py:A 假設、B 典型、C 常數)

  ISL 最大距離 5000 km(B,光學 ISL 的常見量級);掠過高度 100 km 以上才算視線通(A);
  閘道:本島東(花蓮)、西(台中)、南(屏東)各一座,坐標為泛用假設(A);
  再生式的星上處理與交換延遲每一跳 0.5 ms(A)。

## 驗證

  1. 巢狀單調:彎管 <= f=1/24 <= 1/12 <= 1/6 <= 全 ISL <= 涵蓋(至少一顆可見)
  2. 連通性:scipy 的連通元件與 networkx 獨立比對;ISL 視線以沿線取樣獨立比對
  3. 延遲下界:任何路徑的長度不可短於使用者到最近閘道的直線距離
"""
import csv
import math
import os
import sys
import time

import numpy as np

import tw_sweep as W

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")

C_KMS = 299792.458
ISL_MAX_KM = 5000.0
ISL_CLEAR_KM = 100.0
PROC_MS = 0.5
USER_EL, GW_EL = 25.0, 10.0
GATEWAYS = [("東(花蓮)", 23.99, 121.60), ("西(台中)", 24.25, 120.55), ("南(屏東)", 22.37, 120.59)]
REGIONS = [("本島周邊", 23.75, 120.96), ("澎湖", 23.57, 119.60), ("金門", 24.46, 118.38),
           ("馬祖", 26.16, 119.95), ("東沙", 20.70, 116.72), ("太平島", 10.38, 114.36)]
PHI = 0.6180339887498949


def isl_rank(N, offset=0.0):
    """黃金比例序;排名越前越早被選為具 ISL 的衛星。回傳依排名排序的衛星索引。"""
    r = (np.arange(N) * PHI + offset) % 1.0
    return np.argsort(r, kind="stable")


def isl_set(N, f_den, offset=0.0):
    k = max(1, int(round(N / f_den)))
    return np.sort(isl_rank(N, offset)[:k])


def isl_adjacency(P):
    """P:(k,3) 地固座標(km)。回傳 (鄰接布林矩陣, 距離矩陣)。"""
    A = P[:, None, :]
    B = P[None, :, :]
    D = B - A
    d2 = (D ** 2).sum(-1)
    d = np.sqrt(d2)
    with np.errstate(divide="ignore", invalid="ignore"):
        t = np.clip(-(A * D).sum(-1) / np.where(d2 > 0, d2, 1.0), 0.0, 1.0)
    closest = np.linalg.norm(A + t[..., None] * D, axis=-1)
    adj = (d <= ISL_MAX_KM) & (closest >= W.RE + ISL_CLEAR_KM)
    np.fill_diagonal(adj, False)
    return adj, d


def region_index(lat, lon):
    cl = [W.grid_unit(a, b) for _n, a, b in REGIONS]
    G = W.grid_unit(lat, lon)
    return np.argmax(np.stack([G @ c for c in cl], axis=1), axis=1)


class Design:
    """一個星座設計的幾何快取:每個時刻的衛星位置、可見矩陣、閘道可見。"""

    def __init__(self, N, P, F, inc, h, grid, hours=24.0, dt=120.0):
        self.N, self.h = N, h
        a, i, raan0, u0 = W.walker_elements(N, P, F, inc, h)
        self.a = a
        self.times = np.arange(0.0, hours * 3600.0, dt)
        self.S = W.sat_ecef(a, i, raan0, u0, self.times)                    # (T,N,3) km
        self.Su = self.S / a
        self.lat, self.lon, self.w = grid
        self.G = W.grid_unit(self.lat, self.lon)
        self.cos_user = math.cos(W.lam_limit(h, USER_EL))
        self.cos_gw = math.cos(W.lam_limit(h, GW_EL))
        self.GW = np.stack([W.grid_unit(la, lo) for _n, la, lo in GATEWAYS])   # (3,3)
        self.region = region_index(self.lat, self.lon)

    def step(self, t):
        """回傳 (vis (M,N) 布林, 使用者-衛星距離 (M,N), gw可見 (N,), 衛星-最近可見閘道距離 (N,))。"""
        Su = self.Su[t]
        dots = self.G @ Su.T
        vis = dots >= self.cos_user
        dist = np.sqrt(np.maximum(self.a ** 2 + W.RE ** 2 - 2 * self.a * W.RE * dots, 0.0))
        if self.GW.shape[0] == 0:                                            # 沒有任何閘道(韌性分析用)
            return vis, dist, np.zeros(Su.shape[0], dtype=bool), np.full(Su.shape[0], np.inf)
        gd = self.GW @ Su.T                                                  # (3,N)
        gvis_each = gd >= self.cos_gw
        gdist = np.sqrt(np.maximum(self.a ** 2 + W.RE ** 2 - 2 * self.a * W.RE * gd, 0.0))
        gdist = np.where(gvis_each, gdist, np.inf)
        return vis, dist, gvis_each.any(axis=0), gdist.min(axis=0)


def sat_latency_to_gateway(S_t, sat_gvis, sat_gdist, isl_idx):
    """每顆衛星到閘道的最短單程時間(ms)與「是否能到閘道」。

    彎管衛星:只能靠自己看到閘道。具 ISL 的衛星:多源 Dijkstra,
    起點為各具 ISL 且看得到閘道的衛星(初始值 = 到閘道的光行時間)。
    """
    from scipy.sparse import csr_matrix
    from scipy.sparse.csgraph import dijkstra, connected_components
    N = len(sat_gvis)
    lat_ms = np.where(sat_gvis, sat_gdist / C_KMS * 1000.0, np.inf)           # 彎管:自己看到閘道
    ok = sat_gvis.copy()
    if len(isl_idx) >= 2:
        adj, d = isl_adjacency(S_t[isl_idx])
        k = len(isl_idx)
        w = np.where(adj, d / C_KMS * 1000.0 + PROC_MS, 0.0)
        src = np.where(sat_gvis[isl_idx], sat_gdist[isl_idx] / C_KMS * 1000.0, np.inf)
        # 虛擬起點 = 節點 k,連到每個看得到閘道的具 ISL 衛星,邊權 = 該衛星到閘道的時間
        M = np.zeros((k + 1, k + 1))
        M[:k, :k] = w
        for j in range(k):
            if np.isfinite(src[j]):
                M[k, j] = max(src[j], 1e-9)
        dist = dijkstra(csr_matrix(M), directed=True, indices=k)[:k]
        lat_ms[isl_idx] = np.minimum(lat_ms[isl_idx], dist)
        ok[isl_idx] = np.isfinite(lat_ms[isl_idx])
    elif len(isl_idx) == 1:
        pass                                                                      # 單一節點:無 ISL 可用
    return lat_ms, ok


def evaluate(design, f_den, offset=0.0, stride=1):
    """f_den = 0 -> 彎管;>0 -> 具 ISL 比例 1/f_den;f_den = 1 -> 全部衛星具 ISL。"""
    N = design.N
    isl_idx = np.array([], dtype=int) if f_den == 0 else isl_set(N, f_den, offset)
    T = len(design.times)
    M = len(design.lat)
    served = np.zeros(M)
    covered = np.zeros(M)
    lat_samples = []
    steps = range(0, T, stride)
    for t in steps:
        vis, dist, gvis, gdist = design.step(t)
        L, ok = sat_latency_to_gateway(design.S[t], gvis, gdist, isl_idx)
        one_way = dist / C_KMS * 1000.0 + L[None, :]
        one_way = np.where(vis, one_way, np.inf)
        best = one_way.min(axis=1)
        s = np.isfinite(best)
        served += s
        covered += vis.any(axis=1)
        lat_samples.append(best[s] * 2.0)                  # 往返
    n = len(steps)
    served /= n
    covered /= n
    rtt = np.concatenate(lat_samples) if lat_samples else np.array([np.nan])
    reg = {name: float(np.average(served[design.region == k], weights=design.w[design.region == k]))
           for k, (name, _a, _b) in enumerate(REGIONS) if (design.region == k).any()}
    return {"avail": float(np.average(served, weights=design.w)),
            "coverage": float(np.average(covered, weights=design.w)),
            "rtt_p50_ms": float(np.percentile(rtt, 50)), "rtt_p95_ms": float(np.percentile(rtt, 95)),
            "regions": reg, "n_isl": int(len(isl_idx))}


# ---------------------------------------------------------------- 驗證
def verify():
    grid = W.load_grid()
    ok_all = True
    d = Design(96, 8, 5, 25.0, 800.0, grid, hours=6.0, dt=120.0)
    # 1. 巢狀單調
    res = {fd: evaluate(d, fd) for fd in (0, 24, 12, 6, 1)}
    seq = [res[0]["avail"], res[24]["avail"], res[12]["avail"], res[6]["avail"], res[1]["avail"], res[0]["coverage"]]
    print("  巢狀單調(96 顆、800 km):彎管 %.3f <= 1/24 %.3f <= 1/12 %.3f <= 1/6 %.3f <= 全ISL %.3f <= 涵蓋 %.3f"
          % tuple(seq))
    mono = all(b >= a - 1e-12 for a, b in zip(seq, seq[1:]))
    print("    -> %s" % ("通過" if mono else "不單調"))
    ok_all &= mono
    # 2a. 連通元件:scipy vs networkx
    import networkx as nx
    from scipy.sparse import csr_matrix
    from scipy.sparse.csgraph import connected_components
    mism = 0
    checks = 0
    for t in range(0, len(d.times), 12):
        idx = isl_set(d.N, 6)
        adj, _ = isl_adjacency(d.S[t][idx])
        n1, lab = connected_components(csr_matrix(adj), directed=False)
        G = nx.from_numpy_array(adj.astype(int))
        comps = list(nx.connected_components(G))
        same = len(comps) == n1 and all(len(set(lab[list(c)])) == 1 for c in comps)
        mism += not same
        checks += 1
    print("  連通元件 scipy vs networkx:%d 個時刻,%d 個不一致" % (checks, mism))
    ok_all &= mism == 0
    # 2b. ISL 視線:解析最近距離 vs 沿線取樣
    rng = np.random.default_rng(1)
    bad = 0
    tests = 300
    for _ in range(tests):
        t = int(rng.integers(0, len(d.times)))
        i, j = rng.choice(d.N, 2, replace=False)
        A, B = d.S[t, i], d.S[t, j]
        adj, _ = isl_adjacency(np.stack([A, B]))
        samp = A[None, :] + np.linspace(0, 1, 2001)[:, None] * (B - A)[None, :]
        clear = np.linalg.norm(samp, axis=1).min() >= W.RE + ISL_CLEAR_KM
        want = (np.linalg.norm(B - A) <= ISL_MAX_KM) and clear
        bad += bool(adj[0, 1]) != bool(want)
    print("  ISL 視線 解析 vs 取樣:%d 組,%d 個不一致" % (tests, bad))
    ok_all &= bad <= 1                                   # 取樣間距造成的邊界容許 1 組
    # 3. 延遲下界
    worst = np.inf
    for t in range(0, len(d.times), 6):
        vis, dist, gvis, gdist = d.step(t)
        L, _ok = sat_latency_to_gateway(d.S[t], gvis, gdist, isl_set(d.N, 6))
        one_way = np.where(vis, dist / C_KMS * 1000.0 + L[None, :], np.inf).min(axis=1)
        s = np.isfinite(one_way)
        if not s.any():
            continue
        # 使用者到最近閘道的直線(弦)距離 -> 光行時間下界
        ug = np.stack([np.linalg.norm((d.G[:, None, :] - g[None, None, :] * 1.0)[:, 0, :], axis=1) for g in d.GW], axis=1)
        chord_ms = ug.min(axis=1) * W.RE / C_KMS * 1000.0
        worst = min(worst, float((one_way[s] - chord_ms[s]).min()))
    print("  延遲下界:所有已服務樣本的單程延遲 - 到最近閘道的直線光行時間,最小值 %.3f ms(應 >= 0)" % worst)
    ok_all &= worst >= 0
    print("驗證:%s" % ("PASS" if ok_all else "FAIL"))
    return ok_all


def main(argv):
    if "--verify" in argv:
        return 0 if verify() else 1
    print("先跑驗證 ...")
    if not verify():
        return 1
    import pandas as pd
    wb = pd.read_csv(os.path.join(RES, "walker_best.csv"))
    wb = wb[(wb.limit == "practical") & (wb.inc_label == "25") & (wb.el_deg == 25.0)]
    grid = W.load_grid()
    rows = []
    t0 = time.time()
    for h in (550.0, 800.0, 1200.0):
        for N in (48, 72, 96, 144, 192, 240):
            r = wb[(wb.h_km == h) & (wb.N == N)].iloc[0]
            d = Design(int(r.N), int(r.P), int(r.F), float(r.inc_deg), h, grid)
            for fd in (0, 24, 12, 6, 1):
                offs = (0.0,) if fd in (0, 1) else (0.0, 0.31, 0.67)
                res = [evaluate(d, fd, o) for o in offs]
                av = [x["avail"] for x in res]
                regs = {k: float(np.mean([x["regions"][k] for x in res])) for k in res[0]["regions"]}
                rows.append([h, N, int(r.P), int(r.F), fd, res[0]["n_isl"], "%.4f" % np.mean(av), "%.4f" % min(av),
                             "%.4f" % res[0]["coverage"], "%.1f" % np.mean([x["rtt_p50_ms"] for x in res]),
                             "%.1f" % np.mean([x["rtt_p95_ms"] for x in res])]
                            + ["%.4f" % regs[k] for k in sorted(regs)])
                print("h=%4.0f N=%3d f=%s  可用度 %.3f(最差起點 %.3f)  涵蓋 %.3f  RTT p50 %.1f ms  (%.0f s)"
                      % (h, N, ("彎管" if fd == 0 else "1/%d" % fd), np.mean(av), min(av), res[0]["coverage"],
                         np.mean([x["rtt_p50_ms"] for x in res]), time.time() - t0), flush=True)
    reg_names = sorted([n for n, _a, _b in REGIONS])
    with open(os.path.join(RES, "isl_trade.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["h_km", "N", "P", "F", "f_den", "n_isl", "avail_mean", "avail_min", "coverage",
                    "rtt_p50_ms", "rtt_p95_ms"] + ["avail_" + n for n in reg_names])
        w.writerows(rows)
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""節 5 補充:ISL 比例的「拐點」。企劃指定 1/24、1/12、1/6;結果顯示在 1/6 之後才開始有效,
所以另外掃 1/3、1/2 來找門檻。只看太平島(唯一受架構影響的地區)與整體。"""
import os

import numpy as np
import pandas as pd

import tw_isl as I
import tw_sweep as W

HERE = os.path.dirname(os.path.abspath(__file__))
wb = pd.read_csv(os.path.join(HERE, "results", "walker_best.csv"))
wb = wb[(wb.limit == "practical") & (wb.inc_label == "25") & (wb.el_deg == 25.0)]
grid = W.load_grid()
rows = []
for h, N in ((550.0, 144), (550.0, 240), (800.0, 72), (800.0, 96)):
    r = wb[(wb.h_km == h) & (wb.N == N)].iloc[0]
    d = I.Design(int(r.N), int(r.P), int(r.F), float(r.inc_deg), h, grid)
    for fd in (0, 24, 12, 6, 3, 2, 1):
        offs = (0.0,) if fd in (0, 1) else (0.0, 0.31, 0.67)
        res = [I.evaluate(d, fd, o) for o in offs]
        tp = np.mean([x["regions"]["太平島"] for x in res])
        ov = np.mean([x["avail"] for x in res])
        rtt = np.mean([x["rtt_p50_ms"] for x in res])
        rows.append([h, N, fd, res[0]["n_isl"], ov, tp, rtt])
        print("h=%4.0f N=%3d  f=%-5s 具ISL %3d 顆  整體 %.3f  太平島 %.3f  RTT p50 %.1f ms"
              % (h, N, "彎管" if fd == 0 else "1/%d" % fd, res[0]["n_isl"], ov, tp, rtt), flush=True)
pd.DataFrame(rows, columns=["h_km", "N", "f_den", "n_isl", "avail", "avail_taiping", "rtt_p50_ms"]).to_csv(
    os.path.join(HERE, "results", "isl_knee.csv"), index=False)
# -*- coding: utf-8 -*-
r"""節 4:用戶鏈路與饋線鏈路預算(解析模型)。

    python tw_link.py            # 產生 results/link_budget.csv、link_budget.png,並自我驗證
    python tw_link.py --verify   # 只跑驗證

## 參數來源類別

每個參數標一個類別,財務長與學生都該知道哪些數字是「假設」:

  A = 假設(沒有來源,為研究選的合理量級;敏感度分析會掃它)
  B = 典型量級(公開文獻與商用 LEO 寬頻系統的常見範圍,非特定系統的實際值)
  C = 物理常數或定義

所有數字都不代表任何實際計畫。雨衰用「固定允許量」表示(A),沒有套 ITU-R P.618 逐地點計算;
STK 的 Comm 模組可算,留待 STK 交叉驗證階段。

## 模型

  C/N0 = EIRP - 路徑損耗 + G/T - k(dBW/K/Hz = -228.6)
  路徑損耗 = 自由空間 + 大氣 + 雨(允許量)+ 指向 + 極化
  可達速率 = BW * 效率 * log2(1 + SNR / gap),gap 為相對 Shannon 的實作差距;效率含協定負擔

鏈路取上行與下行較差者。
"""
import csv
import math
import os
import sys

import numpy as np

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")

C_LIGHT = 299792.458         # km/s                                   [C]
RE = 6378.137                # km                                      [C]
K_DB = -228.6                # Boltzmann 常數,dBW/K/Hz                 [C]

# ---- 參數表:(值, 單位, 類別, 說明)--------------------------------------
PARAMS = {
    # 用戶下行(衛星 -> 終端),Ku
    "dl_freq_ghz":   (12.0,  "GHz",   "B", "Ku 頻段下行"),
    "dl_bw_mhz":     (250.0, "MHz",   "B", "單一載波頻寬"),
    "sat_eirp_dbw":  (36.0,  "dBW",   "A", "衛星每波束 EIRP(波束邊緣)"),
    "ut_gt_dbk":     (10.0,  "dB/K",  "B", "用戶終端 G/T(約 0.5 m 平板陣列)"),
    # 用戶上行(終端 -> 衛星),Ku
    "ul_freq_ghz":   (14.25, "GHz",   "B", "Ku 頻段上行"),
    "ul_bw_mhz":     (60.0,  "MHz",   "B", "單一載波頻寬"),
    "ut_eirp_dbw":   (36.0,  "dBW",   "B", "用戶終端 EIRP"),
    "sat_gt_dbk":    (6.0,   "dB/K",  "A", "衛星接收 G/T(波束邊緣)"),
    # 共同損耗
    "atm_db":        (0.4,   "dB",    "B", "氣體吸收(仰角 25° 附近),隨仰角依 1/sin(el) 縮放"),
    "rain_db":       (3.0,   "dB",    "A", "雨衰允許量(Ku,99.9% 可用度的粗估)"),
    "pointing_db":   (0.5,   "dB",    "A", "指向與追蹤損耗"),
    "pol_db":        (0.3,   "dB",    "A", "極化失配"),
    # 調變編碼
    "gap_db":        (2.5,   "dB",    "B", "相對 Shannon 的實作差距(DVB-S2X 級)"),
    "eff":           (0.80,  "",      "A", "協定與框架負擔後的效率"),
    "se_cap":        (4.5,   "b/s/Hz", "B", "頻譜效率上限(高階調變上限)"),
    # 饋線(閘道 <-> 衛星),Ka
    "fd_freq_ghz":   (19.5,  "GHz",   "B", "Ka 頻段饋線下行"),
    "fu_freq_ghz":   (29.5,  "GHz",   "B", "Ka 頻段饋線上行"),
    "gw_el_deg":     (10.0,  "deg",   "A", "閘道最低仰角"),
    "gw_eirp_dbw":   (70.0,  "dBW",   "A", "閘道 EIRP(約 2.4 m 天線 + 功率放大器)"),
    "gw_gt_dbk":     (30.0,  "dB/K",  "B", "閘道 G/T"),
    "fsat_eirp_dbw": (45.0,  "dBW",   "A", "衛星饋線下行 EIRP"),
    "fsat_gt_dbk":   (14.0,  "dB/K",  "A", "衛星饋線上行 G/T"),
    "feeder_rain_db": (10.0, "dB",    "A", "Ka 雨衰允許量(閘道有站分集時可降)"),
}


def p(name):
    return PARAMS[name][0]


def slant_range_km(h_km, el_deg):
    """衛星高度 h、終端仰角 el 的斜距(閉合式)。"""
    s = math.sin(math.radians(el_deg))
    return -RE * s + math.sqrt((RE * s) ** 2 + h_km ** 2 + 2 * RE * h_km)


def fspl_db(d_km, f_ghz):
    return 20 * math.log10(4 * math.pi * d_km * 1000.0 * f_ghz * 1e9 / (C_LIGHT * 1000.0))


def rate_mbps(snr_db, bw_mhz):
    snr = 10 ** ((snr_db - p("gap_db")) / 10)
    se = min(p("se_cap"), p("eff") * math.log2(1 + snr))
    return bw_mhz * se


def user_link(h_km, el_deg, rain=True):
    d = slant_range_km(h_km, el_deg)
    atm = p("atm_db") * math.sin(math.radians(25.0)) / math.sin(math.radians(el_deg))
    loss_extra = atm + (p("rain_db") if rain else 0.0) + p("pointing_db") + p("pol_db")
    dl = (p("sat_eirp_dbw") - fspl_db(d, p("dl_freq_ghz")) - loss_extra + p("ut_gt_dbk") - K_DB
          - 10 * math.log10(p("dl_bw_mhz") * 1e6))
    ul = (p("ut_eirp_dbw") - fspl_db(d, p("ul_freq_ghz")) - loss_extra + p("sat_gt_dbk") - K_DB
          - 10 * math.log10(p("ul_bw_mhz") * 1e6))
    return {"range_km": d, "delay_ms": d / C_LIGHT * 1000, "snr_dl_db": dl, "snr_ul_db": ul,
            "rate_dl_mbps": rate_mbps(dl, p("dl_bw_mhz")), "rate_ul_mbps": rate_mbps(ul, p("ul_bw_mhz"))}


def feeder_link(h_km, rain=True):
    el = p("gw_el_deg")
    d = slant_range_km(h_km, el)
    extra = (p("feeder_rain_db") if rain else 0.0) + 1.0            # 1 dB:大氣與指向
    bw = 500.0                                                         # MHz,饋線載波(A)
    dn = (p("fsat_eirp_dbw") - fspl_db(d, p("fd_freq_ghz")) - extra + p("gw_gt_dbk") - K_DB - 10 * math.log10(bw * 1e6))
    up = (p("gw_eirp_dbw") - fspl_db(d, p("fu_freq_ghz")) - extra + p("fsat_gt_dbk") - K_DB - 10 * math.log10(bw * 1e6))
    return {"range_km": d, "snr_dn_db": dn, "snr_up_db": up}


# ---------------------------------------------------------------- 驗證
def verify():
    ok = True
    # 1. 斜距閉合式 vs 向量幾何
    for h in (550.0, 800.0, 1200.0):
        for el in (10.0, 25.0, 40.0, 90.0):
            d_cf = slant_range_km(h, el)
            # 向量法:終端在 (Re, 0),衛星在地心角 lam 處,由仰角條件解 lam,再算距離
            lam = math.acos(RE * math.cos(math.radians(el)) / (RE + h)) - math.radians(el)
            sat = np.array([(RE + h) * math.cos(lam), (RE + h) * math.sin(lam)])
            ut = np.array([RE, 0.0])
            d_vec = float(np.linalg.norm(sat - ut))
            # 仰角還原(獨立檢查向量法本身):與本地垂直方向的夾角
            up = ut / np.linalg.norm(ut)
            los = (sat - ut) / d_vec
            el_back = math.degrees(math.asin(float(np.dot(up, los))))
            if abs(d_cf - d_vec) > 1e-6 * d_cf or abs(el_back - el) > 1e-6:
                ok = False
                print("  斜距不一致 h=%g el=%g:%.4f vs %.4f(仰角還原 %.4f)" % (h, el, d_cf, d_vec, el_back))
    print("  斜距閉合式 vs 向量幾何(12 組):%s" % ("一致" if ok else "不一致"))
    # 2. 自由空間損耗:已知值 —— 1 GHz、1000 km 為 92.45 + 20log10(1) + 20log10(1000) 的 dB 公式
    ref = 92.45 + 20 * math.log10(1.0) + 20 * math.log10(1000.0)
    got = fspl_db(1000.0, 1.0)
    print("  FSPL(1 GHz, 1000 km)= %.3f dB;公式 92.45+20logf+20logd = %.3f dB" % (got, ref))
    ok &= abs(got - ref) < 0.01
    # 3. 速率函數單調且受上限限制
    rs = [rate_mbps(s, 250.0) for s in range(-5, 30)]
    mono = all(b >= a - 1e-9 for a, b in zip(rs, rs[1:]))
    cap = max(rs) <= 250.0 * p("se_cap") + 1e-9
    print("  速率對 SNR 單調:%s;不超過頻譜效率上限:%s" % (mono, cap))
    ok &= mono and cap
    # 4. 物理合理性:同仰角下高度越高,斜距越長、SNR 越低
    s1, s2 = user_link(550.0, 25.0)["snr_dl_db"], user_link(1200.0, 25.0)["snr_dl_db"]
    print("  同仰角下 550 km 的下行 SNR %.2f dB > 1200 km 的 %.2f dB:%s" % (s1, s2, s1 > s2))
    ok &= s1 > s2
    print("驗證:%s" % ("PASS" if ok else "FAIL"))
    return ok


def main(argv):
    if not verify():
        return 1
    if "--verify" in argv:
        return 0
    os.makedirs(RES, exist_ok=True)
    rows = []
    for h in (550.0, 800.0, 1200.0):
        for el in (25.0, 40.0, 60.0, 90.0):
            for rain in (False, True):
                r = user_link(h, el, rain)
                rows.append([h, el, "雨" if rain else "晴", "%.0f" % r["range_km"], "%.2f" % r["delay_ms"],
                             "%.2f" % r["snr_dl_db"], "%.2f" % r["snr_ul_db"],
                             "%.0f" % r["rate_dl_mbps"], "%.0f" % r["rate_ul_mbps"]])
    with open(os.path.join(RES, "link_budget.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["h_km", "el_deg", "weather", "range_km", "one_way_ms", "snr_dl_db", "snr_ul_db",
                    "rate_dl_mbps", "rate_ul_mbps"])
        w.writerows(rows)
    print("\n用戶鏈路(每個 250 MHz 下行載波 / 60 MHz 上行載波)")
    print("%6s %4s %3s %7s %6s %7s %7s %8s %8s" % ("h_km", "el", "天候", "斜距km", "單程ms", "SNR_DL", "SNR_UL", "下行Mbps", "上行Mbps"))
    for r in rows:
        print("%6.0f %4.0f %3s %7s %6s %7s %7s %8s %8s" % tuple([r[0], r[1]] + r[2:]))
    print("\n饋線(閘道仰角 %.0f°,雨衰允許量 %.0f dB):" % (p("gw_el_deg"), p("feeder_rain_db")))
    for h in (550.0, 800.0, 1200.0):
        fl = feeder_link(h)
        print("  h=%4.0f  斜距 %5.0f km  下行 SNR %.1f dB  上行 SNR %.1f dB" % (h, fl["range_km"], fl["snr_dn_db"], fl["snr_up_db"]))
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""替「無最小距離限制」的最佳相位表(walker_best_nosep.csv)補上每一列的星座內最小距離。

這份表是失敗注入與反例的材料:它是第一輪最佳相位搜尋的結果(只看涵蓋率),
補上 min_sep_km 之後,可以直接看出哪些設計其實飛不了(最小距離趨近 0)。
"""
import os

import pandas as pd

import tw_sep as S

HERE = os.path.dirname(os.path.abspath(__file__))
p = os.path.join(HERE, "results", "walker_best_nosep.csv")
d = pd.read_csv(p)
if "min_sep_km" not in d.columns:
    d["min_sep_km"] = float("nan")
    d["n_checked"] = 0
cache = {}
for i, r in d.iterrows():
    key = (int(r.N), int(r.P), int(r.F), float(r.inc_deg), float(r.h_km))
    if key not in cache:
        cache[key] = S.min_sep(*key)[0]
    d.at[i, "min_sep_km"] = round(cache[key], 3)
d.to_csv(p, index=False)
bad = d[d.min_sep_km < 20]
print("無限制版本共 %d 列,其中最小距離 < 20 km 的有 %d 列(%.0f%%);最小距離 < 1 km 的有 %d 列"
      % (len(d), len(bad), 100 * len(bad) / len(d), int((d.min_sep_km < 1).sum())))
print(bad[["N", "P", "F", "h_km", "inc_label", "limit", "avail", "min_sep_km"]].head(12).to_string(index=False))
# -*- coding: utf-8 -*-
r"""節 9:營運 —— 換手、測控(TT&C)、星座內避碰、對既有星座的交會篩選。

    python tw_ops.py --verify
    python tw_ops.py                  # -> results/ops_*.csv

四個子題(各自有驗證):
  (a) 換手:使用者終端「黏著」目前的衛星,直到它不可用(離開 25° 或閘道不可見)才換;
      回報每小時換手次數、服務中斷次數與時間。
  (b) 測控:兩個 TT&C 站(台北、屏東,A 假設),仰角 10° 以上的接觸:每星每天幾次、多長、最長間隔、
      同時需要幾具天線。
  (c) 星座內避碰:一個 Walker 設計裡所有衛星對的最小距離。同高度、同傾角的星座,
      相對幾何每個軌道週期重複一次,所以只需模擬一個週期;最近點以連續最小化精修。
  (d) 對既有星座的交會篩選:本設計 vs OneWeb(1200 km、87.9°;moda_satapp/tle 的公開星曆),
      24 小時內近距離事件數。**這是篩選等級**:本專案的軌道模型(J2 長期項)與 SGP4 約差 10~20 km,
      所以只適合比較不同設計的相對風險,不能當作真正的交會評估。

## 驗證

  (a) 向量化的換手計數 vs 逐步迴圈的獨立實作,逐節點完全一致
  (b) 接觸時段 vs STK 13.1.0 的 access(取 3 顆衛星、兩個站)
  (c) 最近點距離 vs STK 13.1.0 的衛星對衛星距離(取最近的那一對)
  (d) 事件數對取樣步長不敏感(2 s vs 1 s 的計數差 <= 10%)
"""
import csv
import math
import os
import sys
import time

import numpy as np

import tw_capacity as C
import tw_isl as I
import tw_sweep as W

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")
REPO = os.path.abspath(os.path.join(HERE, os.pardir))
REF = [(550.0, 240), (800.0, 144), (1200.0, 96)]
STATIONS = [("Taipei", 25.03, 121.56), ("Pingtung", 22.50, 120.60)]       # A 假設
TTC_EL = 10.0


def ref_params(h, N):
    r = C.load_best()
    r = r[(r.h_km == h) & (r.N == N)].iloc[0]
    return int(r.P), int(r.F), float(r.inc_deg)


# ------------------------------------------------------------------ (a) 換手
def sticky_serving(vis_ok, el):
    """vis_ok:(T,N) 布林(該節點對各衛星是否可用),el:(T,N) 仰角。回傳每步的服務衛星索引(-1 = 無)。"""
    T, N = vis_ok.shape
    cur = -1
    out = np.full(T, -1, dtype=int)
    for t in range(T):
        if cur >= 0 and vis_ok[t, cur]:
            out[t] = cur
            continue
        cand = np.flatnonzero(vis_ok[t])
        cur = int(cand[np.argmax(el[t, cand])]) if cand.size else -1
        out[t] = cur
    return out


def count_events(serving, dt):
    """換手、取得(無 -> 有)、中斷(有 -> 無)次數,與中斷總秒數。"""
    ho = acq = out = 0
    gap_steps = int((serving < 0).sum())
    for a, b in zip(serving[:-1], serving[1:]):
        if a >= 0 and b >= 0 and a != b:
            ho += 1
        elif a < 0 and b >= 0:
            acq += 1
        elif a >= 0 and b < 0:
            out += 1
    return ho, acq, out, gap_steps * dt


def handover_stats(h, N, dt=15.0, hours=24.0):
    P, F, inc = ref_params(h, N)
    d = C.make_design(h, N, C.load_best(), hours=hours, dt=dt)
    T, M = len(d.times), len(d.lat)
    ok = np.zeros((T, M, N), dtype=bool)
    el = np.zeros((T, M, N))
    for t in range(T):
        vis, dist, gvis, _g = d.step(t)
        dots = (d.a ** 2 + W.RE ** 2 - dist ** 2) / (2 * d.a * W.RE)
        el[t] = np.degrees(np.arcsin(np.clip((d.a * dots - W.RE) / dist, -1, 1)))
        ok[t] = vis & gvis[None, :]
    rows = []
    for j, node in enumerate(C.NODES):
        s = sticky_serving(ok[:, j, :], el[:, j, :])
        ho, acq, out, gap = count_events(s, dt)
        rows.append((node[0], ho / hours, out, gap / 60.0))
    return rows, ok, el, d


# ------------------------------------------------------------------ (b) 測控
def ttc_contacts(h, N, dt=10.0):
    P, F, inc = ref_params(h, N)
    a, i, raan0, u0 = W.walker_elements(N, P, F, inc, h)
    times = np.arange(0.0, 86400.0, dt)
    S = W.sat_ecef(a, i, raan0, u0, times) / a
    G = np.stack([W.grid_unit(la, lo) for _n, la, lo in STATIONS])             # (2,3)
    cos_lim = math.cos(W.lam_limit(h, TTC_EL))
    dots = np.einsum("sk,tnk->tsn", G, S)                                      # (T,2,N)
    vis = dots >= cos_lim
    return vis, times


def windows(flag, dt):
    """布林序列 -> [(開始秒, 結束秒), ...](沿時間軸;不處理首尾環繞)。"""
    f = np.concatenate([[False], flag, [False]])
    idx = np.flatnonzero(f[1:] != f[:-1])
    return [(idx[k] * dt, idx[k + 1] * dt) for k in range(0, len(idx), 2)]


def ttc_stats(h, N):
    vis, times = ttc_contacts(h, N)
    dt = times[1] - times[0]
    anyst = vis.any(axis=1)                                                    # (T,N) 任一站可見
    cnt, dur, gap = [], [], []
    for n in range(N):
        w = windows(anyst[:, n], dt)
        cnt.append(len(w))
        dur += [(b - a) / 60 for a, b in w]
        gap += [(w[k + 1][0] - w[k][1]) / 3600 for k in range(len(w) - 1)]
    peak = [int(vis[:, s, :].sum(axis=1).max()) for s in range(len(STATIONS))]
    mean_conc = [float(vis[:, s, :].sum(axis=1).mean()) for s in range(len(STATIONS))]
    return {"contacts_per_sat_day": float(np.mean(cnt)), "contact_min_mean": float(np.mean(dur)),
            "max_gap_h": float(np.max(gap)) if gap else 24.0, "peak_antennas": peak, "mean_concurrent": mean_conc,
            "sats_lt4": int(sum(1 for c in cnt if c < 4))}, vis, times


# ------------------------------------------------------------------ (c) 星座內最近距離
def min_separation(h, N, dt=1.0, thresh_km=150.0):
    """星座內最小距離(實作在 tw_sep.py,與最佳相位搜尋共用同一支)。

    回傳 ((最小距離 km, 衛星 p, 衛星 q, 時刻 s), 候選數, 週期 s, 軌道參數)。
    沒有任何一對在 thresh_km 以內時,最小距離回報 thresh_km(意思是「>= thresh_km」)。"""
    import tw_sep as S
    P, F, inc = ref_params(h, N)
    dmin, p, q, t, nc, period = S.min_sep(N, P, F, inc, h, dt=dt, thresh_km=thresh_km)
    return (dmin, p, q, t), nc, period, W.walker_elements(N, P, F, inc, h)


# ------------------------------------------------------------------ (d) 對 OneWeb 的篩選
def load_tle_pairs(path):
    with open(path, encoding="utf-8") as f:
        lines = [x.rstrip() for x in f if x.strip()]
    return [(lines[k], lines[k + 1]) for k in range(0, len(lines) - 1, 2) if lines[k].startswith("1 ")]


def oneweb_screen(h, N, jd0=2461280.5, dt=2.0, hours=24.0, radius_km=60.0):
    from scipy.spatial import cKDTree
    from sgp4.api import Satrec, SatrecArray
    from sgp4.propagation import gstime
    pairs = load_tle_pairs(os.path.join(REPO, "moda_satapp", "tle", "leo_oneweb.tce"))
    sats = SatrecArray([Satrec.twoline2rv(a, b) for a, b in pairs])
    P, F, inc = ref_params(h, N)
    a, i, raan0, u0 = W.walker_elements(N, P, F, inc, h)
    times = np.arange(0.0, hours * 3600.0, dt)
    # 本設計(地固)與 OneWeb(TEME -> 地固,用同一個格林威治恆星時)放到同一個地固系比較
    gmst0 = float(gstime(jd0))
    ours = W.sat_ecef(a, i, raan0, u0, times, gmst0)                            # (T,N,3)
    jd = np.full(len(times), jd0)
    fr = times / 86400.0
    e, r, _v = sats.sgp4(jd, fr)                                               # r: (n,T,3) TEME
    ang = gmst0 + W.OMEGA_E * times
    c, s = np.cos(ang), np.sin(ang)
    x = c[None, :] * r[:, :, 0] + s[None, :] * r[:, :, 1]
    y = -s[None, :] * r[:, :, 0] + c[None, :] * r[:, :, 1]
    theirs = np.stack([x, y, r[:, :, 2]], axis=-1)                              # (n,T,3)
    theirs = np.where(np.isnan(theirs), 1e7, theirs)
    hits = {}
    for t in range(len(times)):
        tree = cKDTree(theirs[:, t, :])
        res = tree.query_ball_point(ours[t], radius_km)
        for oi, lst in enumerate(res):
            for tj in lst:
                d = float(np.linalg.norm(ours[t, oi] - theirs[tj, t]))
                hits.setdefault((oi, tj), []).append((t, d))
    # 把相鄰時間步的命中合成事件,取事件內最小距離(二次內插)
    events = []
    for key, lst in hits.items():
        lst.sort()
        grp = [lst[0]]
        for it in lst[1:]:
            if it[0] - grp[-1][0] <= 30:                 # 60 s 內視為同一事件
                grp.append(it)
            else:
                events.append(grp)
                grp = [it]
        events.append(grp)
    mins = []
    for g in events:
        k = int(np.argmin([x[1] for x in g]))
        mins.append(g[k][1])
    return np.array(mins), len(pairs)


# ------------------------------------------------------------------ 驗證
def verify():
    ok = True
    h, N = 800.0, 144
    # (a) 換手:向量化 vs 逐步獨立迴圈(在較短的時間窗上)
    rows, okm, el, d = handover_stats(h, N, dt=30.0, hours=6.0)
    mism = 0
    for j in (0, 4, 8, 9):
        s = sticky_serving(okm[:, j, :], el[:, j, :])
        # 獨立實作:逐步,不用 numpy 向量運算判斷
        cur, ho, out = -1, 0, 0
        for t in range(okm.shape[0]):
            if cur >= 0 and okm[t, j, cur]:
                continue
            best, bel = -1, -1.0
            for n in range(N):
                if okm[t, j, n] and el[t, j, n] > bel:
                    best, bel = n, el[t, j, n]
            if cur >= 0 and best >= 0:
                ho += 1
            elif cur >= 0 and best < 0:
                out += 1
            cur = best
        h2, _a, o2, _g = count_events(s, 30.0)
        mism += (h2 != ho) or (o2 != out)
    print("  (a) 換手計數:向量化 vs 獨立迴圈,4 個節點,%d 個不一致" % mism)
    ok &= mism == 0
    # (d) 事件數對取樣步長不敏感
    m2, _n = oneweb_screen(1200.0, 96, dt=2.0, hours=6.0)
    m1, _n = oneweb_screen(1200.0, 96, dt=1.0, hours=6.0)
    c2, c1 = int((m2 < 50).sum()), int((m1 < 50).sum())
    rel = abs(c2 - c1) / max(c1, 1)
    print("  (d) OneWeb 篩選(1200 km / 96 顆,6 小時):取樣 2 s 的事件數 %d,1 s 的 %d(差 %.0f%%)" % (c2, c1, 100 * rel))
    ok &= rel <= 0.10 or abs(c2 - c1) <= 1
    print("驗證(不含 STK 對照):%s" % ("PASS" if ok else "FAIL"))
    return ok


def main(argv):
    if "--verify" in argv:
        return 0 if verify() else 1
    if not verify():
        return 1
    t0 = time.time()
    ho_rows, ttc_rows, sep_rows, ow_rows = [], [], [], []
    for h, N in REF:
        hs, _o, _e, _d = handover_stats(h, N)
        for name, hph, outn, outmin in hs:
            ho_rows.append([h, N, name, "%.2f" % hph, outn, "%.1f" % outmin])
        main_n = [x for x in hs if x[0] in ("本島北", "本島中", "本島南", "本島東")]
        print("(a) h=%4.0f N=%3d  本島節點換手 %.1f 次/小時、中斷 %d 次/日;太平島 換手 %.1f 次/小時、中斷 %d 次、共 %.0f 分/日   (%.0f s)"
              % (h, N, np.mean([x[1] for x in main_n]), int(sum(x[2] for x in main_n)),
                 [x for x in hs if x[0] == "太平島"][0][1], [x for x in hs if x[0] == "太平島"][0][2],
                 [x for x in hs if x[0] == "太平島"][0][3], time.time() - t0), flush=True)
        st, _v, _t = ttc_stats(h, N)
        ttc_rows.append([h, N, "%.1f" % st["contacts_per_sat_day"], "%.1f" % st["contact_min_mean"],
                         "%.1f" % st["max_gap_h"], st["peak_antennas"][0], st["peak_antennas"][1],
                         "%.2f" % st["mean_concurrent"][0], "%.2f" % st["mean_concurrent"][1], st["sats_lt4"]])
        print("(b) h=%4.0f N=%3d  每星每日接觸 %.1f 次、平均 %.1f 分、最長間隔 %.1f 小時;同時在視 台北 峰值 %d / 屏東 峰值 %d;不足 4 次的衛星 %d 顆"
              % (h, N, st["contacts_per_sat_day"], st["contact_min_mean"], st["max_gap_h"], st["peak_antennas"][0],
                 st["peak_antennas"][1], st["sats_lt4"]), flush=True)
        (dmin, p, q, tt), ncand, period, _el = min_separation(h, N)
        sep_rows.append([h, N, "%.2f" % dmin, p, q, "%.2f" % tt, ncand, "%.1f" % (period / 60)])
        if ncand == 0:
            print("(c) h=%4.0f N=%3d  星座內最近距離 >= %.0f km(沒有任何一對靠近到這個距離;週期 %.1f 分)   (%.0f s)"
                  % (h, N, dmin, period / 60, time.time() - t0), flush=True)
        else:
            print("(c) h=%4.0f N=%3d  星座內最近距離 %.2f km(衛星 %d 與 %d,t=%.1f s;候選 %d;週期 %.1f 分)   (%.0f s)"
                  % (h, N, dmin, p, q, tt, ncand, period / 60, time.time() - t0), flush=True)
        mins, n_ow = oneweb_screen(h, N)
        ow_rows.append([h, N, n_ow, int((mins < 10).sum()), int((mins < 25).sum()), int((mins < 50).sum()), int(len(mins))])
        print("(d) h=%4.0f N=%3d  對 OneWeb(%d 顆)24 小時:最近距離 < 10 km %d 件、< 25 km %d 件、< 50 km %d 件(<60 km 共 %d 件)   (%.0f s)"
              % (h, N, n_ow, (mins < 10).sum(), (mins < 25).sum(), (mins < 50).sum(), len(mins), time.time() - t0), flush=True)
    for name, hdr, rows in (
            ("ops_handover.csv", ["h_km", "N", "node", "handovers_per_hour", "outages", "outage_min_per_day"], ho_rows),
            ("ops_ttc.csv", ["h_km", "N", "contacts_per_sat_day", "contact_min_mean", "max_gap_h", "peak_antennas_taipei",
                             "peak_antennas_pingtung", "mean_conc_taipei", "mean_conc_pingtung", "sats_lt4_contacts"], ttc_rows),
            ("ops_separation.csv", ["h_km", "N", "min_sep_km", "sat_p", "sat_q", "t_s", "candidates", "period_min"], sep_rows),
            ("ops_oneweb.csv", ["h_km", "N", "oneweb_sats", "lt10km", "lt25km", "lt50km", "lt60km_events"], ow_rows)):
        with open(os.path.join(RES, name), "w", newline="", encoding="utf-8") as f:
            w = csv.writer(f)
            w.writerow(hdr)
            w.writerows(rows)
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""節 2/3 的圖:可用度對星數(最佳 Walker 相位,實務上限 P<=24)。"""
import os
import sys

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
sys.path.insert(0, os.path.join(HERE, os.pardir, "tools"))
from cjk import use_cjk   # noqa: E402

use_cjk()
d = pd.read_csv(os.path.join(HERE, "results", "walker_best.csv"))
x = d[d.limit == "practical"]
fig, axs = plt.subplots(1, 3, figsize=(13, 4.2), sharey=True)
colors = {"25": "#1b6ca8", "53": "#d1802b", "70": "#6a8e3a", "SSO": "#8a5a9e"}
for ax, h in zip(axs, (550.0, 800.0, 1200.0)):
    for lab, g in x[x.h_km == h].groupby("inc_label"):
        g = g.sort_values("N")
        ax.plot(g.N, g.avail * 100, "o-", color=colors[lab], label=("太陽同步" if lab == "SSO" else "傾角 %s°" % lab))
    ax.axhline(99, color="#999", ls="--", lw=0.8)
    ax.set_title("高度 %.0f km" % h)
    ax.set_xlabel("衛星數 N(最佳相位,P 不超過 24)")
    ax.set_xscale("log")
    ax.set_xticks([24, 48, 96, 192])
    ax.set_xticklabels(["24", "48", "96", "192"])
    ax.grid(alpha=0.3)
axs[0].set_ylabel("服務區平均可用度(%,至少 1 顆可見)")
axs[0].legend(fontsize=8, loc="lower right")
fig.suptitle("台灣服務區(各島海岸 100 海浬)涵蓋:仰角門檻 25°", fontsize=12)
fig.tight_layout()
p = os.path.join(HERE, "results", "coverage_vs_N.png")
fig.savefig(p, dpi=140)
print("寫出", p)
# -*- coding: utf-8 -*-
r"""節 6、7 的圖:容量與服務比例、韌性。"""
import os
import sys

import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
sys.path.insert(0, os.path.join(HERE, os.pardir, "tools"))
from cjk import use_cjk   # noqa: E402

use_cjk()
R = os.path.join(HERE, "results")
COL = {550.0: "#1b6ca8", 800.0: "#d1802b", 1200.0: "#6a8e3a"}

# ---- 容量
c = pd.read_csv(os.path.join(R, "capacity.csv"))
c = c[c.weather == "晴"]
fig, ax = plt.subplots(1, 2, figsize=(11, 4.2))
for h, g in c.groupby("h_km"):
    ax[0].plot(g.N, g.capacity_ceiling_gbps, "o-", color=COL[h], label="%.0f km" % h)
    ax[1].plot(g.N, g.frac_base * 100, "o-", color=COL[h], label="%.0f km" % h)
ax[0].set_ylabel("容量上限(Gbps,時間平均)")
ax[0].set_title("區域平均能送出的最大流量(假設饋線 2 GHz)")
ax[1].axhline(99, color="#999", ls="--", lw=0.8)
ax[1].set_ylabel("基準需求被滿足的比例(%)")
ax[1].set_title("基準需求 17.1 Gbps 的服務比例")
for a in ax:
    a.set_xlabel("衛星數 N(傾角 25°,最佳相位)")
    a.grid(alpha=0.3)
    a.legend()
fig.tight_layout()
fig.savefig(os.path.join(R, "capacity.png"), dpi=140)

# ---- 韌性
d = pd.read_csv(os.path.join(R, "resilience.csv"))
fig, axs = plt.subplots(1, 2, figsize=(11, 4.2))
refs = [(550.0, 240), (800.0, 144), (1200.0, 96)]
labels = ["基準", "失效 5%", "失效 10%", "-10 dB", "-15 dB", "-20 dB"]
keys = [("S0", "基準"), ("S1", "失效 5%"), ("S1", "失效 10%"), ("S3", "使用者鏈路 -10 dB"),
        ("S3", "使用者鏈路 -15 dB"), ("S3", "使用者鏈路 -20 dB")]
import numpy as np
w = 0.27
for i, (h, N) in enumerate(refs):
    g = d[(d.h_km == h) & (d.N == N)]
    vals = []
    for sc, key in keys:
        x = g[(g.scenario == sc) & g.detail.str.contains(key, regex=False) & ~g.detail.str.contains("最差")]
        vals.append(float(x.frac_mean.iloc[0]) * 100)
    axs[0].bar(np.arange(len(keys)) + (i - 1) * w, vals, w, color=COL[h], label="%.0f km / %d 顆" % (h, N))
axs[0].set_xticks(range(len(keys)))
axs[0].set_xticklabels(labels, fontsize=9)
axs[0].set_ylim(0, 105)
axs[0].set_ylabel("服務比例(%)")
axs[0].set_title("衛星失效與使用者鏈路劣化")
axs[0].legend(fontsize=8, loc="lower left")
for i, (h, N) in enumerate(refs):
    g = d[(d.h_km == h) & (d.N == N) & (d.scenario == "S1") & d.detail.str.contains("平均") & d.detail.str.contains("%")]
    p05 = []
    for f in ("5%", "10%"):
        x = d[(d.h_km == h) & (d.N == N) & (d.scenario == "S1") & d.detail.str.contains("失效 " + f, regex=False) & d.detail.str.contains("平均")]
        p05.append(float(x.frac_p05.iloc[0]) * 100)
    axs[1].bar(np.arange(2) + (i - 1) * w, p05, w, color=COL[h])
axs[1].set_xticks([0, 1])
axs[1].set_xticklabels(["失效 5%", "失效 10%"])
axs[1].set_ylim(0, 105)
axs[1].set_ylabel("最差 5% 時刻的服務比例(%)")
axs[1].set_title("看最差的時刻,不是平均")
for a in axs:
    a.grid(alpha=0.3, axis="y")
fig.tight_layout()
fig.savefig(os.path.join(R, "resilience.png"), dpi=140)
print("寫出 capacity.png、resilience.png")
# -*- coding: utf-8 -*-
r"""節 8:衛星壽命、補網政策、離軌與發射次數。

    python tw_replenish.py --verify
    python tw_replenish.py            # -> results/replenish.csv、decay_deorbit.csv

## 模型與參數(類別同 tw_link.py:A 假設、B 典型量級、C 常數;沒有任何一項是特定計畫的實際值)

壽命與失效:
  設計壽命 L = 5 年(A);設計壽命內存活率 90%(A),失效服從指數分布;部署即失效(DOA)機率 2%(A)。
  到壽命的衛星由「預排的接替」無縫換下(假設),所以缺額只來自**失效**。

補網政策(三種,差別只在「失效後多久補上」):
  A 地面備份、隨需發射:接替延遲 6 個月(A)
  B 每年一次批次發射:接替延遲 U(0, 12 個月),平均 6 個月
  C 每個軌道面一顆軌道備份:接替延遲 1 個月(相位調整,A);備份衛星要多造 P 顆

缺額 -> 服務比例:用 degradation_curve.csv(節 7 的失效模型)線性內插。

軌道衰減:圓軌道 da/dt = -sqrt(mu a) rho B,B = Cd A/m;密度用 week10 的 Vallado 指數大氣表
(靜態,代表中等太陽活動;太陽週期的變動用密度倍率 0.4 / 1 / 2.5 帶過,A)。
  衰減壽命的**終點**定為 a 降到 200 km。1000 km 以上的密度沿用表尾的標高外推。
離軌:把近地點降到 50 km 的 delta-V(week10 的 deorbit_dv),推進劑由火箭方程算,Isp = 220 s(A)。

發射:衛星質量 150 kg(A);運載火箭到 550 km / 25° 的運力 1500 kg(A),
800 km 打 85%、1200 km 打 60%(A),扣 10% 適配器;每次發射載 k = floor(運力 / 衛星質量) 顆。

## 驗證

  1. 補網模擬 vs 閉合式:更新過程的穩態在線比例 = tau / (tau + D)(tau = 平均失效間隔)
  2. 衰減積分 vs 常標高大氣的解析式:t = H (1 - exp(-n)) / (sqrt(mu a0) rho0 B)(從 a0 降 n 個標高)
  3. 離軌 delta-V 與 week10 的參考值(550 km:143.3 m/s)一致
  4. 質量守恆:推進劑 = m0 (1 - exp(-dv/(Isp g0)))
"""
import csv
import importlib.util
import math
import os
import sys

import numpy as np

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")
REPO = os.path.abspath(os.path.join(HERE, os.pardir))

MU = 398600.4418e9           # m^3/s^2
RE_KM = 6378.137
G0 = 9.80665
YEAR_S = 365.25 * 86400.0

PARAMS = {
    "life_years":       (5.0,   "yr",   "A", "設計壽命"),
    "survive_life":     (0.90,  "",     "A", "設計壽命內存活率"),
    "doa":              (0.02,  "",     "A", "部署即失效機率"),
    "delay_ground_yr":  (0.5,   "yr",   "A", "政策 A 的接替延遲"),
    "delay_orbit_yr":   (1.0 / 12, "yr", "A", "政策 C 的接替延遲(軌道備份,相位調整)"),
    "sat_mass_kg":      (150.0, "kg",   "A", "衛星質量"),
    "launch_cap_kg":    (1500.0, "kg",  "A", "運載火箭到 550 km / 25° 的運力"),
    "cd":               (2.2,   "",     "B", "阻力係數"),
    "area_m2":          (1.5,   "m^2",  "A", "平均迎風面積(翻滾)"),
    "isp_s":            (220.0, "s",    "A", "離軌推進 Isp"),
    "decay_deorbit_yr": (5.0,   "yr",   "A", "離軌時限(5 年規則,為假設,未查證台灣法規)"),
}
CAP_DERATE = {550.0: 1.0, 800.0: 0.85, 1200.0: 0.60}


def P(name):
    return PARAMS[name][0]


def _week10():
    spec = importlib.util.spec_from_file_location(
        "w10dv", os.path.join(REPO, "week10_propulsion", "week10_propulsion_deltav.py"))
    m = importlib.util.module_from_spec(spec)
    spec.loader.exec_module(m)
    return m


W10 = _week10()


def failure_rate():
    """指數失效率(1/年),使設計壽命內存活率 = survive_life。"""
    return -math.log(P("survive_life")) / P("life_years")


def simulate(N, policy, years=10.0, runs=200, seed=0, dt=1.0 / 52):
    """蒙地卡羅:每個軌道位置(slot)是一個更新過程。回傳每週的缺額比例陣列 (runs, steps)。

    政策 C 每面一顆軌道備份:缺額只在同一面的失效數超過 1 顆備份時才出現,
    面數 P_planes 需傳入 N 以外的參數 -> 用 policy = ("C", planes)。"""
    rng = np.random.default_rng(seed)
    lam = failure_rate()
    steps = int(years / dt)
    t_grid = np.arange(steps) * dt
    out = np.zeros((runs, steps))
    if isinstance(policy, tuple):
        kind, planes = policy
    else:
        kind, planes = policy, 0
    for r in range(runs):
        down = np.zeros((N, steps), dtype=bool)
        for s in range(N):
            t = 0.0
            first = True
            while t < years:
                # 一顆衛星的服役:壽命到(預排接替,無縫)或失效
                life = P("life_years")
                if first and rng.random() < P("doa"):
                    tf = 0.0
                else:
                    tf = rng.exponential(1.0 / lam)
                first = False
                if tf >= life:
                    # 預排接替,不產生缺額;下一顆新衛星同樣獨立抽樣
                    t += life
                    continue
                t_fail = t + tf
                if kind == "A":
                    delay = P("delay_ground_yr")
                elif kind == "B":
                    delay = rng.uniform(0.0, 1.0)
                else:
                    delay = P("delay_orbit_yr")
                a, b = int(t_fail / dt), int(min(t_fail + delay, years) / dt)
                if b > a:
                    down[s, a:b] = True
                t = t_fail + delay
        if kind == "C":
            per = N // planes
            miss = np.zeros(steps)
            for pl in range(planes):
                d = down[pl * per:(pl + 1) * per].sum(axis=0)
                miss += np.maximum(d - 1, 0)          # 一顆備份頂一顆失效
            out[r] = miss / N
        else:
            out[r] = down.sum(axis=0) / N
    return t_grid, out


def steady_state_closed_form(delay_yr):
    """更新過程:在線 tau、離線 D 交替 -> 離線比例 D / (tau + D);tau 為失效前的平均服役時間。

    衛星最長服役 L(到期預排接替,視為重新開始一個新週期),所以有效的 tau = E[min(T, L)]。"""
    lam = failure_rate()
    L = P("life_years")
    tau = (1 - math.exp(-lam * L)) / lam            # E[min(T,L)] 指數分布
    # 每個週期:服役 min(T, L);若 T < L 才有 D 的缺額,機率 1 - exp(-lam L)
    p_fail = 1 - math.exp(-lam * L)
    return (p_fail * delay_yr) / (tau + p_fail * delay_yr)


def degradation_interp(h, N):
    import pandas as pd
    d = pd.read_csv(os.path.join(RES, "degradation_curve.csv"))
    g = d[(d.h_km == h) & (d.N == N)].sort_values("missing_frac")
    return lambda m: np.interp(m, g.missing_frac.values, g.frac_mean.values)


# ---------------------------------------------------------------- 衰減與離軌
def decay_lifetime_years(h_km, rho_scale=1.0, a_end_km=200.0, cd_a_over_m=None, dt_days=2.0):
    """數值積分圓軌道衰減,回傳從 h_km 降到 a_end_km 的年數(超過 500 年回傳 inf)。"""
    if cd_a_over_m is None:
        cd_a_over_m = P("cd") * P("area_m2") / P("sat_mass_kg")
    a = (RE_KM + h_km) * 1000.0
    t = 0.0
    dt = dt_days * 86400.0
    while a > (RE_KM + a_end_km) * 1000.0:
        alt = a / 1000.0 - RE_KM
        rho = rho_scale * W10.atmos_density(alt)
        da = -math.sqrt(MU * a) * rho * cd_a_over_m * dt
        if rho < 1e-20 or da > -1e-6:
            if rho * math.sqrt(MU * a) * cd_a_over_m * YEAR_S < 1e-3:       # 一年掉不到 1 mm
                return float("inf")
        a += da
        t += dt
        if t > 500 * YEAR_S:
            return float("inf")
        # 低空時縮小步長,避免一步穿過
        if alt < 300:
            dt = min(dt, 0.1 * 86400.0)
    return t / YEAR_S


def deorbit_budget(h_km):
    """離軌(近地點降到 50 km)的 delta-V(m/s)與推進劑質量(kg)。"""
    dv_kms = float(W10.deorbit_dv(RE_KM + h_km))            # km/s
    dv = dv_kms * 1000.0
    m0 = P("sat_mass_kg")
    prop = m0 * (1 - math.exp(-dv / (P("isp_s") * G0)))
    return dv, prop


def sats_per_launch(h):
    cap = P("launch_cap_kg") * CAP_DERATE[h] * 0.9
    return max(1, int(cap // P("sat_mass_kg")))


# ---------------------------------------------------------------- 驗證
def verify():
    ok = True
    # 1. 補網模擬 vs 閉合式(政策 A、C 之外,用 A 與 B 的平均延遲驗證)
    N = 300
    for kind, delay in (("A", P("delay_ground_yr")), ("B", 0.5)):
        _t, out = simulate(N, kind, years=10.0, runs=60, seed=2)
        sim = float(out[:, 52:].mean())                 # 去掉第一年的暫態
        cf = steady_state_closed_form(delay)
        print("  政策 %s:模擬穩態缺額 %.4f;閉合式 %.4f(差 %.4f)" % (kind, sim, cf, abs(sim - cf)))
        ok &= abs(sim - cf) < 0.35 * cf + 0.0008
    # 2. 衰減:常標高大氣的解析式 vs 數值積分(自建一個單一指數大氣,獨立於 week10 的表)
    H, rho0, a0_alt = 60.0, 1e-12, 500.0                # km, kg/m^3, km
    B = 0.01
    a0 = (RE_KM + a0_alt) * 1000.0
    Hm = H * 1000.0
    # 從 a0 降到 a0 - 4H:積分 dt = da / (-sqrt(mu a) rho(a) B),rho(a) = rho0 exp(-(a - a0)/H)
    a_end = a0 - 4 * Hm
    n = 20000
    aa = np.linspace(a_end, a0, n)
    f = 1.0 / (np.sqrt(MU * aa) * rho0 * np.exp(-(aa - a0) / Hm) * B)
    t_num = float(np.trapezoid(f, aa)) / YEAR_S
    t_ana = (Hm * (1 - math.exp(-4)) / (math.sqrt(MU * a0) * rho0 * B)) / YEAR_S     # 以 a0 處的 sqrt(mu a) 近似;積分 e^((a-a0)/H) 從 a0-4H 到 a0
    err = abs(t_num - t_ana) / t_ana
    print("  衰減積分(單一指數大氣,降 4 個標高):數值 %.3f 年;解析近似 %.3f 年(差 %.1f%%)" % (t_num, t_ana, 100 * err))
    ok &= err < 0.05
    # 2b. 本模組的積分器對同一個大氣給同樣的結果(把 week10 的密度函數換成這個單一指數大氣)
    orig = W10.atmos_density
    W10.atmos_density = lambda alt_km: rho0 * math.exp(-(alt_km - a0_alt) / H)
    try:
        t_mod = decay_lifetime_years(a0_alt, a_end_km=a0_alt - 4 * H, cd_a_over_m=B)
    finally:
        W10.atmos_density = orig
    err2 = abs(t_mod - t_num) / t_num
    print("  本模組積分器(同一大氣):%.3f 年 vs 獨立數值積分 %.3f 年(差 %.1f%%)" % (t_mod, t_num, 100 * err2))
    ok &= err2 < 0.05
    # 3. 離軌 delta-V 對 week10
    dv, prop = deorbit_budget(550.0)
    print("  離軌 delta-V(550 km)= %.1f m/s;week10 參考值 143.3 m/s" % dv)
    ok &= abs(dv - 143.3) < 1.0
    # 4. 推進劑守恆
    m_after = P("sat_mass_kg") - prop
    ve = P("isp_s") * G0
    ok &= abs(ve * math.log(P("sat_mass_kg") / m_after) - dv) < 1e-6
    print("  火箭方程往返:delta-V %.3f m/s -> 推進劑 %.2f kg -> delta-V %.3f m/s" % (
        dv, prop, ve * math.log(P("sat_mass_kg") / m_after)))
    print("驗證:%s" % ("PASS" if ok else "FAIL"))
    return ok


def main(argv):
    if "--verify" in argv:
        return 0 if verify() else 1
    if not verify():
        return 1
    os.makedirs(RES, exist_ok=True)
    refs = [(550.0, 240), (800.0, 144), (1200.0, 96)]
    rows = []
    print("\n衰減與離軌:")
    dec_rows = []
    for h in (550.0, 800.0, 1200.0):
        life = {s: decay_lifetime_years(h, s) for s in (0.4, 1.0, 2.5)}
        dv, prop = deorbit_budget(h)
        k = sats_per_launch(h)
        dec_rows.append([h, "%.1f" % life[0.4], "%.1f" % life[1.0], "%.1f" % life[2.5], "%.1f" % dv, "%.2f" % prop, k])
        fmt = lambda x: ("> 500" if math.isinf(x) else "%.1f" % x)                    # noqa: E731
        print("  h=%4.0f km  自然衰減壽命(太陽活動低/中/高):%s / %s / %s 年   離軌 dV %.0f m/s,推進劑 %.1f kg"
              "   每次發射 %d 顆" % (h, fmt(life[0.4]), fmt(life[1.0]), fmt(life[2.5]), dv, prop, k))
    with open(os.path.join(RES, "decay_deorbit.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["h_km", "decay_yr_low", "decay_yr_mid", "decay_yr_high", "deorbit_dv_ms", "deorbit_prop_kg", "sats_per_launch"])
        w.writerows(dec_rows)
    print("\n補網模擬(10 年,200 次):")
    for h, N in refs:
        f_of = degradation_interp(h, N)
        planes = int(__import__("pandas").read_csv(os.path.join(RES, "walker_best.csv")).query(
            "limit=='practical' and inc_label=='25' and el_deg==25.0 and h_km==@h and N==@N").P.iloc[0])
        for kind, label in (("A", "A 地面備份隨需發射"), ("B", "B 每年批次發射"), (("C", planes), "C 軌道備份")):
            _t, miss = simulate(N, kind, years=10.0, runs=200, seed=11)
            miss = miss[:, 52:]                                    # 去掉第一年暫態
            svc = f_of(miss)
            lam = failure_rate()
            tau = (1 - math.exp(-lam * P("life_years"))) / lam          # E[min(T, L)]:每顆衛星平均服役年數
            build = N * (1 + P("doa")) / tau + (planes / P("life_years") if isinstance(kind, tuple) else 0.0)
            launches = build / sats_per_launch(h)
            spare = planes if isinstance(kind, tuple) else 0
            rows.append([h, N, label, "%.4f" % miss.mean(), "%.4f" % np.percentile(miss, 95),
                         "%.4f" % (miss > 0.10).mean(), "%.4f" % svc.mean(), "%.4f" % np.percentile(svc, 5),
                         "%.1f" % build, "%.1f" % launches, spare])
            print("  h=%4.0f N=%3d %-14s 平均缺額 %.3f  p95 缺額 %.3f  缺額>10%% 的時間 %.3f  服務比例 平均 %.4f / p05 %.4f"
                  "  造星 %.1f 顆/年  發射 %.1f 次/年  備份 %d 顆"
                  % (h, N, label, miss.mean(), np.percentile(miss, 95), (miss > 0.10).mean(), svc.mean(),
                     np.percentile(svc, 5), build, launches, spare))
    with open(os.path.join(RES, "replenish.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["h_km", "N", "policy", "missing_mean", "missing_p95", "time_missing_gt10pct", "svc_mean",
                    "svc_p05", "sats_built_per_year", "launches_per_year", "spares"])
        w.writerows(rows)
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""節 7:韌性 —— 壞掉時還剩多少服務。只做**抽象的可用度分析**,不涉及任何攻擊細節。

    python tw_resilience.py --verify
    python tw_resilience.py            # -> results/resilience.csv

基準設計(三個高度,各取剛好能滿足基準需求且有餘裕的星數):550 km / 240 顆、800 km / 144 顆、
1200 km / 96 顆,傾角 25°,最佳相位;需求為基準情境;彎管架構;晴天。

情境(皆以「服務比例 = 被滿足的需求 / 總需求」衡量,時間平均與最差 5% 時刻):
  S0 基準
  S1 衛星失效:隨機失效 1 顆、5%、10%(巢狀抽樣,5 個種子取平均與最差);另對一個設計逐顆移除,找最關鍵的衛星
  S2 閘道失效:三座閘道的所有子集(8 種)
  S3 使用者鏈路劣化:使用者下行額外損耗 0、3、6、10、15、20 dB(干擾或壓制的抽象代表)
  S4 複合:失去 1 座閘道 + 10% 衛星失效

驗證:
  1. 同一組失效,移除的集合越大,服務比例不增(巢狀)
  2. 閘道越多,服務比例不減
  3. 額外損耗越大,服務比例不增
  4. 不移除任何東西 = 基準(逐位相同);沒有閘道 = 零服務
"""
import csv
import os
import sys
import time

import numpy as np

import tw_capacity as C

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")
REF = [(550.0, 240), (800.0, 144), (1200.0, 96)]
GW_NAMES = ["東", "西", "南"]


def nested_failures(N, seed, fracs):
    """同一個隨機排列的前 k 個 —— 巢狀。回傳 {k: sat_ok 遮罩}。"""
    perm = np.random.default_rng(seed).permutation(N)
    out = {}
    for label, k in fracs:
        m = np.ones(N, dtype=bool)
        m[perm[:k]] = False
        out[label] = m
    return out


def verify():
    wb = C.load_best()
    dem = np.array([n[4] for n in C.NODES])
    d = C.make_design(800.0, 96, wb, hours=6.0, dt=120.0)
    ok = True
    base = C.run(d, dem, False, stride=2)
    same = C.run(d, dem, False, stride=2, sat_ok=np.ones(d.N, dtype=bool), gw_idx=[0, 1, 2], extra_db=0.0)
    ident = abs(base["frac_mean"] - same["frac_mean"]) < 1e-12 and abs(base["gbps_mean"] - same["gbps_mean"]) < 1e-12
    print("  不移除任何東西 = 基準:%s(%.6f vs %.6f)" % ("相同" if ident else "不同", base["frac_mean"], same["frac_mean"]))
    ok &= ident
    none = C.run(d, dem, False, stride=2, gw_idx=[])
    print("  沒有閘道:服務比例 %.6f(應為 0)" % none["frac_mean"])
    ok &= none["frac_mean"] == 0.0
    # 1. 巢狀衛星失效
    fr = [("k1", 1), ("k5", max(1, round(0.05 * d.N))), ("k10", max(2, round(0.10 * d.N)))]
    fm = nested_failures(d.N, 3, fr)
    vals = [C.run(d, dem, False, stride=2, sat_ok=fm[k])["frac_mean"] for k in ("k1", "k5", "k10")]
    mono1 = base["frac_mean"] >= vals[0] - 1e-12 and vals[0] >= vals[1] - 1e-12 and vals[1] >= vals[2] - 1e-12
    print("  衛星失效巢狀:基準 %.4f >= 1 顆 %.4f >= 5%% %.4f >= 10%% %.4f -> %s" % (base["frac_mean"], *vals, "通過" if mono1 else "不單調"))
    ok &= mono1
    # 2. 閘道子集
    f1 = [C.run(d, dem, False, stride=2, gw_idx=g)["frac_mean"] for g in ([0], [0, 1], [0, 1, 2])]
    mono2 = f1[0] <= f1[1] + 1e-12 <= f1[2] + 2e-12
    print("  閘道 1 -> 2 -> 3 座:%.4f -> %.4f -> %.4f -> %s" % (*f1, "通過" if mono2 else "不單調"))
    ok &= mono2
    # 3. 額外損耗
    f3 = [C.run(d, dem, False, stride=2, extra_db=x)["frac_mean"] for x in (0, 3, 6, 10, 20)]
    mono3 = all(b <= a + 1e-12 for a, b in zip(f3, f3[1:]))
    print("  額外損耗 0/3/6/10/20 dB:%s -> %s" % (" / ".join("%.4f" % x for x in f3), "通過" if mono3 else "不單調"))
    ok &= mono3
    print("驗證:%s" % ("PASS" if ok else "FAIL"))
    return ok


def main(argv):
    if "--verify" in argv:
        return 0 if verify() else 1
    if not verify():
        return 1
    wb = C.load_best()
    dem = np.array([n[4] for n in C.NODES])
    rows = []
    t0 = time.time()

    def rec(h, N, scen, detail, r):
        rows.append([h, N, scen, detail, "%.4f" % r["frac_mean"], "%.4f" % r["frac_p05"], "%.2f" % r["gbps_mean"]])
        print("h=%4.0f N=%3d %-6s %-26s 服務比例 %.3f (p05 %.3f)  %.1f Gbps  (%.0f s)"
              % (h, N, scen, detail, r["frac_mean"], r["frac_p05"], r["gbps_mean"], time.time() - t0), flush=True)

    for h, N in REF:
        d = C.make_design(h, N, wb)
        rec(h, N, "S0", "基準", C.run(d, dem, False, stride=2))
        # S1 衛星失效:隨機,巢狀,5 個種子
        for label, k in (("1 顆", 1), ("5%", max(1, round(0.05 * N))), ("10%", max(2, round(0.10 * N)))):
            res = []
            for seed in range(5):
                m = nested_failures(N, seed, [("x", k)])["x"]
                res.append(C.run(d, dem, False, stride=2, sat_ok=m))
            mean = {kk: float(np.mean([x[kk] for x in res])) for kk in ("frac_mean", "frac_p05", "gbps_mean")}
            worst = min(res, key=lambda x: x["frac_mean"])
            rec(h, N, "S1", "失效 %s(%d 顆)平均" % (label, k), mean)
            rec(h, N, "S1", "失效 %s(%d 顆)最差種子" % (label, k), worst)
        # S2 閘道子集
        for mask in range(8):
            idx = [i for i in range(3) if mask >> i & 1]
            name = "+".join(GW_NAMES[i] for i in idx) if idx else "無閘道"
            rec(h, N, "S2", "閘道:" + name, C.run(d, dem, False, stride=2, gw_idx=idx))
        # S3 鏈路劣化
        for x in (0, 3, 6, 10, 15, 20):
            rec(h, N, "S3", "使用者鏈路 -%d dB" % x, C.run(d, dem, False, stride=2, extra_db=float(x)))
        # S4 複合:失去一座閘道 + 10% 衛星
        k = max(2, round(0.10 * N))
        for lost, gi in (("東", [1, 2]), ("西", [0, 2]), ("南", [0, 1])):
            res = [C.run(d, dem, False, stride=2, sat_ok=nested_failures(N, s, [("x", k)])["x"], gw_idx=gi) for s in range(3)]
            rec(h, N, "S4", "失去閘道%s + 10%% 衛星" % lost,
                {kk: float(np.mean([x[kk] for x in res])) for kk in ("frac_mean", "frac_p05", "gbps_mean")})
    # 最關鍵的衛星:對 800 km / 144 顆逐顆移除
    h, N = 800.0, 144
    d = C.make_design(h, N, wb)
    base = C.run(d, dem, False, stride=6)["frac_mean"]
    drops = []
    for s in range(N):
        m = np.ones(N, dtype=bool)
        m[s] = False
        drops.append(base - C.run(d, dem, False, stride=6, sat_ok=m)["frac_mean"])
    drops = np.array(drops)
    print("逐顆移除(800 km / 144 顆,粗取樣):基準 %.4f;單顆失效造成的服務比例損失 最大 %.4f、平均 %.4f、中位數 %.4f"
          % (base, drops.max(), drops.mean(), np.median(drops)))
    rows.append([h, N, "S1", "逐顆移除:最大損失", "%.4f" % drops.max(), "", ""])
    rows.append([h, N, "S1", "逐顆移除:平均損失", "%.4f" % drops.mean(), "", ""])
    with open(os.path.join(RES, "resilience.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["h_km", "N", "scenario", "detail", "frac_mean", "frac_p05", "gbps_mean"])
        w.writerows(rows)
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""節 7 補充:閘道的**地理分散**。三座本島閘道彼此只差 100~200 km,任何一座的可見衛星幾乎相同,
所以閘道數量對可用度沒有幫助,而「全部同時失效」是單一失效點。這裡比較不同閘道布局
(離島閘道的回傳問題不在本分析範圍,只看衛星可見性造成的服務比例)。"""
import os

import numpy as np

import tw_capacity as C
import tw_sweep as W

HERE = os.path.dirname(os.path.abspath(__file__))
wb = C.load_best()
dem = np.array([n[4] for n in C.NODES])
SETS = {
    "本島三座(基準)": [(23.99, 121.60), (24.25, 120.55), (22.37, 120.59)],
    "僅本島一座(花蓮)": [(23.99, 121.60)],
    "僅澎湖": [(23.57, 119.58)],
    "僅金門": [(24.45, 118.38)],
    "本島花蓮 + 澎湖": [(23.99, 121.60), (23.57, 119.58)],
    "本島花蓮 + 金門 + 東沙": [(23.99, 121.60), (24.45, 118.38), (20.70, 116.72)],
    "全離島(澎湖 + 金門 + 東沙)": [(23.57, 119.58), (24.45, 118.38), (20.70, 116.72)],
}
for h, N in ((550.0, 240), (800.0, 144), (1200.0, 96)):
    d = C.make_design(h, N, wb)
    gw0 = d.GW.copy()
    print("== h=%.0f N=%d" % (h, N))
    for name, pts in SETS.items():
        d.GW = np.stack([W.grid_unit(a, b) for a, b in pts])
        r = C.run(d, dem, False, stride=2)
        print("  %-26s 服務比例 %.4f(p05 %.4f)  %.1f Gbps  太平島 %.3f 東沙 %.3f"
              % (name, r["frac_mean"], r["frac_p05"], r["gbps_mean"], r["node_frac"][8], r["node_frac"][7]), flush=True)
    d.GW = gw0
# -*- coding: utf-8 -*-
r"""星座內衛星對的最小距離(Walker 設計的內部安全檢查)。

為什麼是必要的檢查:涵蓋最佳化挑出來的相位,可能讓不同軌道面的兩顆衛星在軌道面交點
同時抵達 —— 最近距離是 0。本章第一輪的「最佳相位」三個參考設計全部如此(兩顆衛星的
RAAN 差 180 度,同時過赤道交點),實際上不能飛。所以最佳相位搜尋要加最小距離的限制。

同高度、同傾角的 Walker,所有衛星的 J2 長期漂移率相同,相對幾何每個軌道週期重複一次,
所以只需模擬一個週期。取樣之間的最近點用連續最小化精修。
"""
import math

import numpy as np

import tw_sweep as W


def min_sep(N, P, F, inc_deg, h_km, dt=3.0, thresh_km=150.0):
    """回傳 (最小距離 km, 衛星 p, 衛星 q, 時刻 s, 候選數, 週期 s)。"""
    from scipy.optimize import minimize_scalar
    from scipy.spatial.distance import pdist
    a, i, raan0, u0 = W.walker_elements(N, P, F, inc_deg, h_km)
    u_dot, _rd = W.rates(a, i)
    period = 2 * math.pi / u_dot
    times = np.arange(0.0, period + dt, dt)
    iu = np.triu_indices(N, 1)
    cand = []
    prev = prev2 = None
    for k, t in enumerate(times):
        dd = pdist(W.sat_ecef(a, i, raan0, u0, np.array([t]))[0])
        if prev is not None and prev2 is not None:
            m = (prev < prev2) & (prev <= dd) & (prev < thresh_km)
            for q in np.flatnonzero(m):
                cand.append((int(iu[0][q]), int(iu[1][q]), times[k - 1]))
        prev2, prev = prev, dd
    best = (float("inf"), -1, -1, 0.0)
    for (p, q, t0) in cand:
        def dist_at(t):
            S2 = W.sat_ecef(a, i, raan0[[p, q]], u0[[p, q]], np.array([t]))[0]
            return float(np.linalg.norm(S2[0] - S2[1]))
        r = minimize_scalar(dist_at, bounds=(t0 - dt, t0 + dt), method="bounded", options={"xatol": 1e-4})
        if r.fun < best[0]:
            best = (float(r.fun), p, q, float(r.x))
    if not cand:                                   # 沒有任何候選 -> 最小距離大於門檻(取樣上界)
        return (thresh_km, -1, -1, 0.0, 0, period)
    return (best[0], best[1], best[2], best[3], len(cand), period)
# -*- coding: utf-8 -*-
r"""STK 13.1.0 交叉驗證:Python 涵蓋引擎 vs STK 的 Walker 星座與 chain access。

    python tw_stk_verify.py            # 需要 STK 13 桌面版

對三個代表性設計(550 km / 144 顆、800 km / 72 顆、1200 km / 48 顆,傾角 25°,取最佳相位),
在 STK 以 Walker 指令建星座(J2 傳播器),於 7 個代表地點(各島)建設施並設 25° 仰角門檻,
取 chain 的 Complete Access 聯集,算 24 小時可用度與最長空窗;
再用 Python 引擎在同一歷元(含格林威治恆星時)算同樣 7 個地點,逐點比對。

已知的差異來源(不是錯誤):
  - Python 只含 J2 長期項,STK 的 J2 傳播器含短週期項,沿軌相位會有些微差
  - 參考架構:STK 的 ICRF 與 Python 的「日期平均赤道」差 25 年歲差約 0.3 度
  - STK 取樣是連續求根,Python 取樣步長 20 秒
容許:每個地點可用度差 <= 0.03(絕對值)。

Connect 的距離單位是**工作階段狀態**(同一個 STK 先前被腳本改成公尺就會一直是公尺),
所以每次先宣告 `Units_SetConnect / Distance km`,否則半長軸給 6928.137 會被當成 6.9 公里而 NACK。
"""
import os
import sys
import time

import numpy as np
import pandas as pd

HERE = os.path.dirname(os.path.abspath(__file__))
sys.path.insert(0, os.path.join(HERE, os.pardir, "stk13_labs", "tools"))
import stk13_env                                    # noqa: E402
import tw_sweep as W                                # noqa: E402

EPOCH = "1 Jan 2025 00:00:00.000"
STOP = "2 Jan 2025 00:00:00.000"
JD_EPOCH = 2460676.5                                # 2025-01-01 00:00 UTC
# 前三個接近飽和(多數地點 100%),只能證明沒有系統性偏差;
# 後三個可用度只有 0.4~0.9,逐點差異才有鑑別力 —— 驗證要看後者。
DESIGNS = [(550.0, 144), (800.0, 72), (1200.0, 48), (550.0, 48), (550.0, 96), (1200.0, 24)]
# STK 的 Connect 物件名稱用 ASCII(中文名稱 New 會被拒);地點:台北、花蓮、澎湖、金門、馬祖、東沙、太平島
SITES = [("Taipei", 25.03, 121.56), ("Hualien", 23.99, 121.60), ("Penghu", 23.57, 119.58),
         ("Kinmen", 24.45, 118.38), ("Matsu", 26.16, 119.95), ("Dongsha", 20.70, 116.72), ("Taiping", 10.38, 114.36)]
EL = 25.0
TOL = 0.03


def merge(iv):
    iv = sorted(iv)
    out = []
    for a, b in iv:
        if out and a <= out[-1][1] + 1e-6:
            out[-1][1] = max(out[-1][1], b)
        else:
            out.append([a, b])
    return out


def stk_site_stats(root, sc, fac_name, const_path):
    """chain facility -> constellation 的聯集可用度與最長空窗(秒)。"""
    chain_name = "C_" + fac_name
    root.ExecuteCommand("New / */Chain %s" % chain_name)
    root.ExecuteCommand("Chains */Chain/%s Add */Facility/%s" % (chain_name, fac_name))
    root.ExecuteCommand("Chains */Chain/%s Add %s" % (chain_name, const_path))
    root.ExecuteCommand("Chains */Chain/%s Compute" % chain_name)
    ch = sc.Children.Item(chain_name)
    r = ch.DataProviders.GetDataPrvIntervalFromPath("Complete Access").Exec(sc.StartTime, sc.StopTime)
    if r.DataSets.Count == 0:
        return 0.0, 86400.0
    st = list(r.DataSets.GetDataSetByName("Start Time").GetValues())
    sp = list(r.DataSets.GetDataSetByName("Stop Time").GetValues())
    from datetime import datetime

    def sec(s):
        return (datetime.strptime(s[:24], "%d %b %Y %H:%M:%S.%f") - datetime(2025, 1, 1)).total_seconds()
    iv = merge([[sec(a), sec(b)] for a, b in zip(st, sp)])
    tot = sum(b - a for a, b in iv)
    edges = [0.0] + [x for ab in iv for x in ab] + [86400.0]
    gaps = [edges[k + 1] - edges[k] for k in range(0, len(edges) - 1, 2)]
    return tot / 86400.0, max(gaps) if gaps else 0.0


def main():
    from sgp4.propagation import gstime
    gmst0 = float(gstime(JD_EPOCH))
    wb = pd.read_csv(os.path.join(HERE, "results", "walker_best.csv"))
    wb = wb[(wb.limit == "practical") & (wb.inc_label == "25") & (wb.el_deg == 25.0)]
    app, root = stk13_env.connect()
    rows = []
    for h, N in DESIGNS:
        r = wb[(wb.h_km == h) & (wb.N == N)].iloc[0]
        P, F = int(r.P), int(r.F)
        S = N // P
        print("\n== h=%.0f km  N=%d  P=%d  F=%d  (每面 %d 顆)" % (h, N, P, F, S))
        if root.CurrentScenario is not None:
            root.CloseScenario()
        root.NewScenario("TW_LEO_Verify")
        sc = root.CurrentScenario
        sc.SetTimePeriod(EPOCH, STOP)
        root.ExecuteCommand("Units_SetConnect / Distance km")
        root.ExecuteCommand("New / */Satellite Seed")
        root.ExecuteCommand('SetState */Satellite/Seed Classical J2Perturbation "%s" "%s" 60 ICRF "%s" %.3f 0.0 %.2f 0.0 0.0 0.0'
                            % (EPOCH, STOP, EPOCH, W.RE + h, 25.0))
        t0 = time.time()
        root.ExecuteCommand("Walker */Satellite/Seed Type Delta NumPlanes %d NumSatsPerPlane %d "
                            "InterPlanePhaseIncrement %d ColorByPlane No ConstellationName WK" % (P, S, F))
        print("  Walker 建立 %.0f 秒;場景內衛星 %d 顆" % (time.time() - t0,
              sum(1 for i in range(sc.Children.Count) if sc.Children.Item(i).ClassName == "Satellite")))
        for name, lat, lon in SITES:
            root.ExecuteCommand("New / */Facility %s" % name)
            root.ExecuteCommand("SetPosition */Facility/%s Geodetic %.4f %.4f 0.0" % (name, lat, lon))
            root.ExecuteCommand("SetConstraint */Facility/%s ElevationAngle Min %.1f" % (name, EL))
        stk = {}
        for name, _la, _lo in SITES:
            stk[name] = stk_site_stats(root, sc, name, "*/Constellation/WK")
        lat = np.array([s[1] for s in SITES])
        lon = np.array([s[2] for s in SITES])
        py = W.coverage(N, P, F, 25.0, h, EL, (lat, lon, np.ones(len(lat))), hours=24.0, dt=20.0, gmst0=gmst0)
        # coverage() 只回彙總;逐點要自己算:用同一核心
        a, inc, raan0, u0 = W.walker_elements(N, P, F, 25.0, h)
        times = np.arange(0.0, 86400.0, 20.0)
        Sx = W.sat_ecef(a, inc, raan0, u0, times, gmst0) / a
        av, _mu, _nv, gm = W._kernel(Sx, W.grid_unit(lat, lon), np.cos(W.lam_limit(h, EL)), 20.0)
        for k, (name, _la, _lo) in enumerate(SITES):
            sa, sg = stk[name]
            rows.append([h, N, name, sa, float(av[k]), sa - float(av[k]), sg, float(gm[k])])
            print("  %-10s  STK 可用度 %.4f  Python %.4f  差 %+.4f   最長空窗 STK %5.0f s / Python %5.0f s"
                  % (name, sa, av[k], sa - av[k], sg, gm[k]))
    df = pd.DataFrame(rows, columns=["h_km", "N", "site", "avail_stk", "avail_py", "diff", "gap_stk_s", "gap_py_s"])
    df.to_csv(os.path.join(HERE, "results", "stk_crosscheck.csv"), index=False)
    worst = df["diff"].abs().max()
    mean = df["diff"].abs().mean()
    print("\n%d 個(設計 x 地點)比對:平均絕對差 %.4f,最大 %.4f(容許 %.2f)" % (len(df), mean, worst, TOL))
    unsat = df[(df.avail_py < 0.995)]
    print("其中可用度未飽和(< 0.995)的有 %d 個,這些的最大差 %.4f、平均差 %.4f"
          % (len(unsat), unsat["diff"].abs().max() if len(unsat) else float("nan"),
             unsat["diff"].abs().mean() if len(unsat) else float("nan")))
    ok = worst <= TOL
    print("驗證:%s" % ("PASS" if ok else "FAIL"))
    return 0 if ok else 1


if __name__ == "__main__":
    raise SystemExit(main())
# -*- coding: utf-8 -*-
r"""Walker 星座對台灣服務區的涵蓋掃描引擎(圓軌道 + J2 長期項,numba 加速)。

模型:
  - Walker delta  i : T/P/F,圓軌道,高度 h;RAAN 與幅角速率含 J2 長期項
  - 地球自轉(忽略歲差與章動),地面格點用 tw_area 產生的服務區網格
  - 可見:仰角 >= el_min,等價於地心角 <= lam(h, el_min)

指標(整個服務區,面積加權):
  avail      至少 1 顆可見的時間比例(面積加權平均)
  avail_p05  最差 5% 面積的可用度(看「最差的地方」,不被平均蓋掉)
  gap_max_s  服務區內最長的無衛星時段(秒)
  nvis_mean  平均同時可見顆數
  multi2     同時 >= 2 顆可見的時間比例(換手餘裕)

驗證(`python tw_sweep.py --verify`):
  1. 閉合式:全球面積加權的平均可見顆數 = N * (1 - cos lam) / 2(任何軌道都精確成立)
  2. 獨立實作:用 sgp4 套件傳播同一組星,涵蓋指標與本模型比對
"""
import math
import os
import sys

import numpy as np

HERE = os.path.dirname(os.path.abspath(__file__))
RES = os.path.join(HERE, "results")

JD_1949 = 2433281.5          # sgp4init 的歷元以 1949-12-31 00:00 UT 起算的天數
MU = 398600.4418            # km^3/s^2
RE = 6378.137               # km
J2 = 1.08262668e-3
OMEGA_E = 7.2921159e-5      # rad/s


def lam_limit(h_km, el_deg):
    """可見的最大地心角(rad)。"""
    el = math.radians(el_deg)
    return math.acos(RE * math.cos(el) / (RE + h_km)) - el


def walker_elements(T, P, F, inc_deg, h_km):
    """回傳 (a, inc, raan0[N], u0[N]);u 為起始緯度幅角。T 必須是 P 的倍數。"""
    assert T % P == 0, "T 必須是 P 的倍數"
    S = T // P
    raan0 = np.repeat(2 * np.pi * np.arange(P) / P, S)
    u0 = (2 * np.pi * np.tile(np.arange(S), P) / S
          + 2 * np.pi * F * np.repeat(np.arange(P), S) / T)
    return RE + h_km, math.radians(inc_deg), raan0, u0


def rates(a, inc):
    """圓軌道的平均角速率:(u_dot, raan_dot)。"""
    n = math.sqrt(MU / a ** 3)
    k = J2 * (RE / a) ** 2
    u_dot = n * (1 + 1.5 * k * (4 * math.cos(inc) ** 2 - 1))
    raan_dot = -1.5 * n * k * math.cos(inc)
    return u_dot, raan_dot


def sat_ecef(a, inc, raan0, u0, times, gmst0=0.0):
    """衛星地固座標,形狀 (T, N, 3),單位 km。gmst0:歷元時刻的格林威治恆星時(rad),
    與其他軟體(如 STK)比對時要給;掃描時不影響統計,預設 0。"""
    u_dot, raan_dot = rates(a, inc)
    t = np.asarray(times, dtype=float)[:, None]
    u = u0[None, :] + u_dot * t
    raan = raan0[None, :] + (raan_dot - OMEGA_E) * t - gmst0   # 同時扣掉地球自轉 -> 地固
    cu, su = np.cos(u), np.sin(u)
    cr, sr = np.cos(raan), np.sin(raan)
    ci, si = math.cos(inc), math.sin(inc)
    x = a * (cr * cu - sr * su * ci)
    y = a * (sr * cu + cr * su * ci)
    z = a * (su * si) * np.ones_like(x)
    return np.stack([x, y, z], axis=-1)


def grid_unit(lat, lon):
    la, lo = np.radians(lat), np.radians(lon)
    return np.stack([np.cos(la) * np.cos(lo), np.cos(la) * np.sin(lo), np.sin(la)], axis=-1)


def _kernel(S, G, cos_lam, dt):
    """S:(T,N,3) 衛星單位向量,G:(M,3) 格點單位向量。回傳每格點的 (可用度, 雙星以上比例, 平均顆數, 最長空窗秒)。

    每個時刻用一次矩陣乘法算出所有格點對所有衛星的餘弦(BLAS),不需要 numba
    (numba 與目前的 NumPy 版本不相容)。
    """
    T = S.shape[0]
    M = G.shape[0]
    avail = np.zeros(M)
    multi = np.zeros(M)
    nsum = np.zeros(M)
    gapmax = np.zeros(M)
    cur = np.zeros(M)
    for t in range(T):
        c = (G @ S[t].T >= cos_lam).sum(axis=1)
        nsum += c
        has = c >= 1
        avail += has
        multi += c >= 2
        cur = np.where(has, 0.0, cur + dt)
        np.maximum(gapmax, cur, out=gapmax)
    return avail / T, multi / T, nsum / T, gapmax


def load_grid():
    d = np.load(os.path.join(RES, "service_grid.npz"))
    return d["lat"], d["lon"], d["w"]


def coverage(T, P, F, inc_deg, h_km, el_deg, grid, hours=24.0, dt=60.0, gmst0=0.0):
    """回傳指標字典。grid = (lat, lon, w)。"""
    lat, lon, w = grid
    a, inc, raan0, u0 = walker_elements(T, P, F, inc_deg, h_km)
    times = np.arange(0.0, hours * 3600.0, dt)
    S = sat_ecef(a, inc, raan0, u0, times, gmst0)
    S = (S / a).astype(np.float64)
    G = grid_unit(lat, lon)
    cos_lam = math.cos(lam_limit(h_km, el_deg))
    av, mu, nv, gm = _kernel(S, G, cos_lam, dt)
    order = np.argsort(av)
    cw = np.cumsum(w[order]) / w.sum()
    worst = cw <= 0.05
    if not worst.any():
        worst = np.zeros_like(cw, dtype=bool)
        worst[0] = True
    p05 = float(np.average(av[order][worst], weights=w[order][worst]))
    return {"avail": float(np.average(av, weights=w)), "avail_p05": p05,
            "gap_max_s": float(gm.max()), "nvis_mean": float(np.average(nv, weights=w)),
            "multi2": float(np.average(mu, weights=w))}


# ---------------------------------------------------------------- 驗證
def verify_closed_form():
    """全球面積加權平均可見顆數 = N (1 - cos lam) / 2。"""
    T, P, F, inc, h, el = 48, 6, 1, 53.0, 550.0, 25.0
    a, i, raan0, u0 = walker_elements(T, P, F, inc, h)
    la = np.arange(-89.5, 90, 1.0)
    lo = np.arange(-179.5, 180, 1.0)
    LO, LA = np.meshgrid(lo, la)
    G = grid_unit(LA.ravel(), LO.ravel())
    wgt = np.cos(np.radians(LA.ravel()))
    cos_lam = math.cos(lam_limit(h, el))
    times = np.arange(0.0, 6 * 3600.0, 300.0)
    S = sat_ecef(a, i, raan0, u0, times) / a
    # 瞬時全球平均,對時間再平均
    tot = []
    for t in range(len(times)):
        vis = (G @ S[t].T >= cos_lam).sum(axis=1)
        tot.append(np.average(vis, weights=wgt))
    got = float(np.mean(tot))
    want = T * (1 - cos_lam) / 2
    err = abs(got - want) / want
    print("  閉合式:全球平均可見顆數 %.3f,N(1-cos lam)/2 = %.3f,差 %.2f%%" % (got, want, 100 * err))
    return err < 0.02


def verify_sgp4():
    """用 sgp4 傳播同一組星,與本模型的位置與涵蓋指標比對。"""
    from sgp4.api import Satrec, WGS84
    T, P, F, inc, h, el = 24, 4, 1, 53.0, 550.0, 25.0
    a, i, raan0, u0 = walker_elements(T, P, F, inc, h)
    n_rad_min = math.sqrt(MU / a ** 3) * 60.0
    epoch = 25000.0                      # 任意歷元(天),只影響地球自轉相位,兩邊同設為 GMST 起點
    # sgp4init 的參數順序:whichconst, opsmode, satn, epoch, bstar, ndot, nddot, ecco, argpo, inclo, mo, no_kozai, nodeo
    sats = []
    for k in range(T):
        s = Satrec()
        s.sgp4init(WGS84, "i", k, epoch, 0.0, 0.0, 0.0, 1e-9, 0.0, i, u0[k], n_rad_min, raan0[k])
        sats.append(s)
    from sgp4.api import jday
    # TEME -> 地固:本模型把 GMST=0 對齊 epoch;sgp4 的 TEME 與慣性系近似相同,
    # 因此用同一個 OMEGA_E*t 轉到地固
    times = np.arange(0.0, 6 * 3600.0, 120.0)
    pos = np.zeros((len(times), T, 3))
    for ti, t in enumerate(times):
        for k, s in enumerate(sats):
            e, r, _v = s.sgp4(JD_1949 + epoch, t / 86400.0)
            if e:
                raise RuntimeError("sgp4 error %d" % e)
            c, sn = math.cos(OMEGA_E * t), math.sin(OMEGA_E * t)
            pos[ti, k] = (c * r[0] + sn * r[1], -sn * r[0] + c * r[1], r[2])
    mine = sat_ecef(a, i, raan0, u0, times)
    # 兩者的軌道平均元素定義略有不同(Kozai/Brouwer),位置差來自沿軌道相位漂移
    dpos = np.linalg.norm(pos - mine, axis=-1)
    print("  sgp4 對照:6 小時內位置差 平均 %.1f km、最大 %.1f km(軌道半徑 %.0f km)" % (
        dpos.mean(), dpos.max(), a))
    # 涵蓋指標比對(同一格點、同一時間,逐格比對可見判定)
    grid = load_grid()
    G = grid_unit(grid[0], grid[1])
    cos_lam = math.cos(lam_limit(h, el))
    agree = []
    for ti in range(len(times)):
        v1 = (G @ (mine[ti] / a).T >= cos_lam).sum(axis=1) >= 1
        v2 = (G @ (pos[ti] / np.linalg.norm(pos[ti], axis=1, keepdims=True)).T >= cos_lam).sum(axis=1) >= 1
        agree.append(np.mean(v1 == v2))
    ag = float(np.mean(agree))
    a1 = float(np.mean([((G @ (mine[ti] / a).T >= cos_lam).sum(axis=1) >= 1).mean() for ti in range(len(times))]))
    a2 = float(np.mean([((G @ (pos[ti] / np.linalg.norm(pos[ti], axis=1, keepdims=True)).T >= cos_lam).sum(axis=1) >= 1).mean() for ti in range(len(times))]))
    print("  逐點逐時刻可見判定一致率 %.2f%%;平均涵蓋 本模型 %.3f / sgp4 %.3f" % (100 * ag, a1, a2))
    return ag > 0.97 and abs(a1 - a2) < 0.03


def main(argv):
    if "--verify" in argv:
        ok1 = verify_closed_form()
        ok2 = verify_sgp4()
        print("驗證:%s" % ("PASS" if ok1 and ok2 else "FAIL"))
        return 0 if ok1 and ok2 else 1
    grid = load_grid()
    r = coverage(48, 6, 1, 53.0, 550.0, 25.0, grid)
    print(r)
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""節 2/3:Walker 星座涵蓋 Trade Study 掃描。

    python tw_trade_coverage.py            # 全掃描 -> results/coverage_sweep.csv
    python tw_trade_coverage.py --quick    # 小範圍試跑

設計變數:星數 N、高度 h、傾角(含依高度求出的太陽同步傾角)、仰角門檻、軌道面數 P(F=1)。
每個設計模擬 24 小時、步長 60 秒,指標見 tw_sweep.py。
"""
import csv
import itertools
import math
import os
import sys
import time

import numpy as np

import tw_sweep as W

HERE = os.path.dirname(os.path.abspath(__file__))
OUT = os.path.join(HERE, "results", "coverage_sweep.csv")

NS = [24, 36, 48, 72, 96, 144, 192, 240]
HS = [550.0, 800.0, 1200.0]
INCS = [25.0, 53.0, 70.0, "SSO"]
ELS = [25.0, 40.0]
RAAN_SSO = 2 * math.pi / (365.2422 * 86400.0)      # rad/s


def sso_inc(h):
    a = W.RE + h
    n = math.sqrt(W.MU / a ** 3)
    k = W.J2 * (W.RE / a) ** 2
    return math.degrees(math.acos(-RAAN_SSO / (1.5 * n * k)))


def plane_choices(N):
    """每個 N 取最接近 sqrt(N) 的兩個合法軌道面數(4 <= P <= N/4)。"""
    ds = [p for p in range(4, N // 4 + 1) if N % p == 0]
    ds.sort(key=lambda p: abs(p - math.sqrt(N)))
    return ds[:2]


def designs(quick=False):
    ns = [24, 72, 240] if quick else NS
    hs = [550.0] if quick else HS
    for N, h, inc, el in itertools.product(ns, hs, INCS, ELS):
        i = sso_inc(h) if inc == "SSO" else inc
        for P in plane_choices(N):
            yield N, P, h, i, el, ("SSO" if inc == "SSO" else "%g" % inc)


def main(argv):
    quick = "--quick" in argv
    grid = W.load_grid()
    rows = list(designs(quick))
    print("設計數 %d" % len(rows))
    t0 = time.time()
    os.makedirs(os.path.dirname(OUT), exist_ok=True)
    with open(OUT if not quick else OUT.replace(".csv", "_quick.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["N", "P", "F", "h_km", "inc_deg", "inc_label", "el_deg",
                    "avail", "avail_p05", "gap_max_s", "nvis_mean", "multi2"])
        for k, (N, P, h, inc, el, lab) in enumerate(rows):
            r = W.coverage(N, P, 1, inc, h, el, grid)
            w.writerow([N, P, 1, h, "%.2f" % inc, lab, el, "%.5f" % r["avail"], "%.5f" % r["avail_p05"],
                        "%.0f" % r["gap_max_s"], "%.3f" % r["nvis_mean"], "%.5f" % r["multi2"]])
            f.flush()
            if k % 20 == 0:
                print("  %4d/%d  N=%3d P=%2d h=%4.0f i=%-5s el=%2.0f  avail=%.3f  p05=%.3f  (%.0f s)"
                      % (k, len(rows), N, P, h, lab, el, r["avail"], r["avail_p05"], time.time() - t0))
    print("完成,%.0f 秒" % (time.time() - t0))
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))
# -*- coding: utf-8 -*-
r"""節 2:對每個 (N, 高度, 傾角) 搜尋最佳 Walker 相位 (P, F)。

為什麼要這一步:第一輪掃描固定 F=1、只試兩個 P,結果對 (P, F) 非常敏感 ——
例如 550 km / 25 度 / 240 顆,P=15 可用度 85.4%、P=16 是 91.0%,而 192 顆 P=12 反而有 99.9%。
這不是模擬的雜訊(24 小時與 7 天的結果相同到小數第三位),是 Walker 相位決定了地面軌跡
重複的方式:區域很小時,星數多不保證涵蓋好。所以「N 顆」要拿最佳相位的 N 顆來比。

做法:
  1. 篩選:縮小格點(每 4 點取 1)、12 小時、步長 120 秒,對所有合法 (P, F) 快速評分
  2. 精算:每個 (N, 高度, 傾角) 取篩選前 3 名,用完整格點、24 小時、步長 60 秒重算
  3. 兩種限制各取最佳:不限軌道面數(any),以及實務上限 P <= 24(practical)。
     軌道面數是成本與營運的驅動項 —— 80 個軌道面(每面 3 顆)涵蓋最好,卻不可能這樣發射與維運。
  4. **最小距離限制**:涵蓋最佳的相位常讓兩顆衛星在軌道面交點同時抵達(最小距離 0),不能飛。
     精算前先對候選檢查星座內最小距離(tw_sep.py),只收 >= MIN_SEP_KM 的候選。
     沒有限制時的結果另存 walker_best_nosep.csv,可看出這個限制讓涵蓋損失多少。
  5. 結果寫到 results/walker_best.csv(每個設計、每種限制一列,含最小距離)
"""
import csv
import math
import os
import sys
import time

import numpy as np

import tw_sep as S
import tw_sweep as W
import tw_trade_coverage as T

HERE = os.path.dirname(os.path.abspath(__file__))
OUT = os.path.join(HERE, "results", "walker_best.csv")
EL = 25.0                        # 預設仰角門檻;--el 40 另存 walker_best_el40.csv
P_PRACTICAL = 24                 # 實務上限:軌道面數(每面一次發射任務)
MIN_SEP_KM = 20.0                # 星座內最小距離下限(A:低於這個值,軌道維持的誤差就會讓兩顆衛星相撞)
N_FEASIBLE_TRY = 40              # 為了找可行的候選,最多檢查篩選排名前幾名


def candidates(N, cap=140):
    out = []
    for P in range(3, N // 3 + 1):
        if N % P:
            continue
        fs = list(range(P)) if P <= 12 else list(range(0, P, 2))
        out += [(P, F) for F in fs]
    if len(out) > cap:                                  # 等距抽樣,保留首尾
        idx = np.linspace(0, len(out) - 1, cap).round().astype(int)
        out = [out[i] for i in sorted(set(idx))]
    return out


def screen_grid(grid, stride=4):
    lat, lon, w = grid
    return lat[::stride], lon[::stride], w[::stride]


def main(argv):
    global EL, OUT
    if "--el" in argv:
        EL = float(argv[argv.index("--el") + 1])
        OUT = OUT.replace(".csv", "_el%g.csv" % EL)
    quick = "--quick" in argv
    grid = W.load_grid()
    sg = screen_grid(grid)
    ns = [24, 72, 240] if quick else T.NS
    hs = [550.0] if quick else T.HS
    incs = [25.0, 53.0] if quick else [25.0, 53.0, 70.0, "SSO"]
    rows = []
    t0 = time.time()
    for N in ns:
        cands = candidates(N)
        for h in hs:
            for inc in incs:
                i = T.sso_inc(h) if inc == "SSO" else inc
                lab = "SSO" if inc == "SSO" else "%g" % inc
                scored = []
                for P, F in cands:
                    r = W.coverage(N, P, F, i, h, EL, sg, hours=12.0, dt=120.0)
                    scored.append((r["avail"], P, F))
                scored.sort(reverse=True)
                spread = scored[0][0] - scored[-1][0]
                for tag, ok in (("any", lambda P: True), ("practical", lambda P: P <= P_PRACTICAL)):
                    pool = [x for x in scored if ok(x[1])]
                    feas = []
                    checked = 0
                    for _a, P, F in pool:
                        if len(feas) >= 3 or checked >= N_FEASIBLE_TRY:
                            break
                        checked += 1
                        ms = S.min_sep(N, P, F, i, h)[0]
                        if ms >= MIN_SEP_KM:
                            feas.append((_a, P, F, ms))
                    if not feas:
                        rows.append([N, 0, 0, h, "%.2f" % i, lab, EL, tag, "nan", "nan", "nan", "nan", "nan",
                                     "%.3f" % spread, len(cands), "nan", checked])
                        print("N=%3d h=%4.0f i=%-5s %-9s 前 %d 名都不可行(最小距離 < %.0f km)" % (N, h, lab, tag, checked, MIN_SEP_KM), flush=True)
                        continue
                    best = None
                    for _a, P, F, ms in feas:
                        r = W.coverage(N, P, F, i, h, EL, grid)
                        if best is None or r["avail"] > best[0]["avail"]:
                            best = (r, P, F, ms)
                    r, P, F, ms = best
                    rows.append([N, P, F, h, "%.2f" % i, lab, EL, tag, "%.5f" % r["avail"], "%.5f" % r["avail_p05"],
                                 "%.0f" % r["gap_max_s"], "%.3f" % r["nvis_mean"], "%.5f" % r["multi2"],
                                 "%.3f" % spread, len(cands), "%.1f" % ms, checked])
                    print("N=%3d h=%4.0f i=%-5s %-9s P=%2d F=%2d  avail=%.4f p05=%.4f  最小距離 %.0f km  (檢查 %d 個候選)  %.0f s"
                          % (N, h, lab, tag, P, F, r["avail"], r["avail_p05"], ms, checked, time.time() - t0), flush=True)
    path = OUT if not quick else OUT.replace(".csv", "_quick.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        w.writerow(["N", "P", "F", "h_km", "inc_deg", "inc_label", "el_deg", "limit", "avail", "avail_p05",
                    "gap_max_s", "nvis_mean", "multi2", "screen_spread", "n_candidates", "min_sep_km", "n_checked"])
        w.writerows(rows)
    return 0


if __name__ == "__main__":
    raise SystemExit(main(sys.argv[1:]))